 |  |  |
Design de Proteínas inspirado pelo Prêmio Nobel com a Wolfram Language
Design de Proteínas inspirado pelo Prêmio Nobel com a Wolfram Language
20 de Abril de 2025
Robert B. Nachbar, Diretor de Projetos Sênior, Wolfram Solutions
Quando li um artigo recente do New York Times sobre IA, não imaginei que estaria seguindo os passos de um ganhador do Prêmio Nobel, mas logo descobri que poderia fazer exatamente isso com a Wolfram Language.
O Prêmio Nobel de Química de 2024 foi concedido pelo design computacional de proteínas e pela previsão de estruturas proteicas, áreas ativamente pesquisadas há várias décadas. Os trabalhos iniciais basearam-se em fundamentos de física e química, tentando modelar o dobramento da cadeia de resíduos de aminoácidos que compõem uma proteína em uma estrutura tridimensional por meio de análise conformacional e energias. Mais recentemente, métodos de IA foram aplicados ao problema, utilizando redes neurais profundas (DNNs) e grandes modelos de linguagem (LLMs), como trRosetta, AlphaFold e ESMFold. O trabalho de David Baker, um dos laureados, foi recentemente destacado em um artigo do New York Times.
Em um artigo de 2021, o grupo de Baker descreveu experimentos computacionais que otimizavam uma sequência aleatória de aminoácidos em uma sequência proteica realista e a dobravam em uma estrutura tridimensional. Esse processo foi repetido 2.000 vezes, gerando uma “ampla variedade de sequências e estruturas previstas”. A parte realmente empolgante veio depois: eles criaram 129 genes sintéticos em laboratório com base nas sequências, inseriram-nos no genoma de bactérias E. coli, isolaram e purificaram as novas proteínas e obtiveram suas estruturas por cristalografia de raios X e espectroscopia de RMN, que corresponderam de forma próxima às estruturas previstas.
Nós nos propusemos a explorar a parte “X computacional” do experimento deles na Wolfram Language. Alguns dos novos recursos da recém-lançada Versão 14.2 tornaram essa tarefa surpreendentemente simples.
Dobrando uma sequência de aminoácidos Vamos começar com uma proteína de estrutura conhecida. O domínio N-terminal da proteína precursora amiloide (APP), associada à doença de Alzheimer, é um bom exemplo. O ID de entrada no Protein Data Bank (PDB) é 1MWP. Podemos recuperar o título da citação para os dados publicados com esta solicitação de conexão de serviço nova na Versão 14.2:
In[]:=
ServiceExecute["RCSBProteinDataBank","EntryData",{"PDBStructureID"ExternalIdentifier["PDBStructureID","1MWP"]}]["Citation",All,"Title"]
Out[]=
E podemos recuperar a estrutura como uma com esta solicitação:
In[]:=
bioMol=ServiceExecute["RCSBProteinDataBank","BioMolecule",{"PDBStructureID"ExternalIdentifier["PDBStructureID","1MWP"]}]
Out[]=
BioMolecule


Também podemos obter o mesmo resultado com muito menos digitação com:
In[]:=
BioMolecule[ExternalIdentifier["PDBStructureID","1MWP"]]
Out[]=
BioMolecule

A estrutura cristalográfica completa é composta por uma única cadeia proteica e muitas moléculas de água que co-cristalizaram com a molécula de proteína. As moléculas de água são agrupadas em sua própria cadeia por conveniência, então a BioMolecule possui duas cadeias:
In[]:=
bioMol["ChainTypes"]
Out[]=
APeptide,BWater
A estrutura da proteína é composta por uma única cadeia que possui duas hélices-α e várias fitas-β, que podem ser visualizadas aqui:
In[]:=
BioMoleculePlot3D[bioMol,ImageSize->Small]
Out[]=

e tabuladas aqui como intervalos de resíduos:
In[]:=
bioMol["Helices"]
Out[]=
A{{38,50},{73,75}}
In[]:=
bioMol["Sheets"]
Out[]=
A{{6,8},{16,18},{25,27},{55,60},{65,67},{70,72},{76,79},{83,85},{88,92}}
O serviço "ESMAtlas” também é novo na Versão 14.2 e permite dobrar uma sequência usando o modelo da Meta AI. Esta é a solicitação de serviço para dobrar a sequência de aminoácidos:
In[]:=
foldedBioMol=ServiceExecute["ESMAtlas","FoldSequence",{"BioSequence"bioMol["BioSequences"]["A"]}]
Out[]=
BioMolecule
A estrutura dobrada também é composta por uma α-hélice e várias fitas-β:
In[]:=
BioMoleculePlot3D[foldedBioMol,ImageSize->Small]
Out[]=

Entretanto, podemos ver aqui que a hélice mais longa na estrutura dobrada por IA é dois resíduos mais curta do que na estrutura cristalográfica, e os resíduos 73, 74 e 75 não formam uma hélice:
In[]:=
foldedBioMol["Helices"]
Out[]=
A{{39,49}}
Duas fitas-β foram perdidas na estrutura dobrada por IA:
In[]:=
foldedBioMol["Sheets"]
Out[]=
A{{6,8},{16,18},{25,27},{55,60},{65,67},{83,85},{88,92}}
Então, quão boa é essa predição de dobra, quantitativamente? O serviço ESMAtlas calcula uma confiança atômica armazenada na propriedade "BFactors" da BioMolecule. Os valores individuais variam de 0 a 1, com valores mais altos indicando maior confiança na posição tridimensional prevista. Aqui estão as confianças atômicas dos átomos dos cinco primeiros resíduos:
In[]:=
foldedBioMol["BFactors"]["A"]//Take[#,5]&
Out[]=
{{0.73,0.76,0.79,0.7,0.76,0.65,0.6,0.62},{0.84,0.85,0.85,0.8,0.82,0.71,0.65,0.66},{0.9,0.91,0.91,0.89,0.9},{0.92,0.92,0.93,0.91,0.92,0.84,0.8,0.78,0.74},{0.93,0.94,0.94,0.93,0.93,0.9,0.89}}
Podemos usar esses valores para calcular uma confiança geral da sequência dobrada, especificamente a raiz quadrada média dos valores atômicos:
In[]:=
confidence[bm_BioMolecule]:=Sqrt@Mean@Flatten[bm["BFactors"]["A"]^2]
In[]:=
confidence[foldedBioMol]
Out[]=
0.818817
Esse valor é bastante alto, então a estrutura dobrada deve estar “próxima” da estrutura experimental, e podemos obter uma comparação numérica exata com a função BioMoleculeAlign, que é um protótipo baseado em :
In[]:=
alignment=BioMoleculeAlign[bioMol,foldedBioMol,"Backbone",All]
Out[]=
TransformationTransformationFunction
,Error,BioMoleculeBioMolecule
-0.476971 | -0.804336 | -0.35432 | |
-0.276896 | -0.245089 | 0.929118 | |
-0.834163 | 0.541272 | -0.105817 | |
0 | 0 | 0 | 1. |

Uma diferença RMS (RMSD) dos átomos do esqueleto de 1,38 Å é bastante boa, e visualmente podemos ver que a estrutura dobrada corresponde de forma bastante próxima à estrutura experimental. Como esperado, o desvio é maior nas extremidades N- e C-terminais da proteína:
In[]:=
Show[BioMoleculePlot3D[bioMol,ColorRules->({_->Darker@Green})],BioMoleculePlot3D[alignment["BioMolecule"],ColorRules->({_->Lighter@Red})],ImageSize->Medium]//Legended[#,SwatchLegend[{Darker@Green,Lighter@Red},{"Experimental","AI folded"}]]&
Out[]=


Para ter uma visão mais ampla da precisão da dobra, fizemos uma busca no site do PDB por proteínas monoméricas de cadeia única com 95 a 105 resíduos, com estrutura determinada por difração de raios X e resolução final de ≤ 2,0 Å:
A busca retornou 175 IDs de entrada (seus resultados podem variar devido a alterações no banco de dados público):
Vamos recuperar cada estrutura, dobrar sua sequência completa, calcular a confiança da dobra e calcular o RMSD em relação à geometria experimental. No entanto, antes de podermos fazer essa tarefa aparentemente simples, precisamos limpar a lista.
A biologia é complexa, especialmente quando se trabalha com dados experimentais. Existem quase 230.000 estruturas determinadas experimentalmente no PDB. Uma grande parte delas tem alta qualidade. Na busca acima, já filtramos as estruturas com baixa resolução (> 2,0 Å) na origem, mas ainda há vários outros possíveis problemas a serem tratados.
Primeiro, os bancos de dados não são perfeitos. Embora a busca tenha especificado “entidades proteicas”, algumas proteínas conjugadas com oligossacarídeos foram incluídas nos resultados. Elas têm o tipo de cadeia "Branched":
Então, vamos remover esses dois resultados:
Segundo, o modelo de dobra de proteínas da Meta AI aceita apenas sequências compostas por um número muito limitado dos mais de 500 aminoácidos naturalmente encontrados, muitos dos quais estão presentes em proteínas do PDB. Existem 21 aminoácidos proteicos codificados pelo DNA, e o ESMFold utiliza apenas 20 deles (a selenometionina é o aminoácido fora da curva).
Os aminoácidos são frequentemente representados por abreviações de três letras, como Ala para alanina, Trp para triptofano, etc. Para ainda mais brevidade, biólogos também usam códigos de uma letra (apenas os aminoácidos proteogênicos têm um), como mostrado nesta tabela:
Podemos usar os códigos de uma letra para criar um filtro:
Vamos testá-lo com a APP que recuperamos do PDB acima:
Até agora, tudo certo. O peptídeo sintético 5V63 foi feito para estudar a oligomerização da proteína β-amiloide e contém ornitina, sarcosina e iodofenilalanina. Ele deve falhar no teste:
Ótimo! Agora, vamos filtrar os resultados:
Terceiro, a cristalografia por raios X não é perfeita. Muitos cristais não são ideais e contêm defeitos. Um defeito comum em cristais de proteínas é a desordem, em que uma parte da proteína não cristaliza da mesma forma em cada célula unitária, e esse fenômeno efetivamente desfoca a densidade eletrônica (são os elétrons que espalham os raios X), e os átomos não podem ser localizados. A desordem frequentemente ocorre nas extremidades da cadeia proteica, mas também pode acontecer onde há alças entre hélices-α e fitas-β.
Para tornar a comparação dos resultados de dobramento proteico mais informativa, devemos remover os resultados que apresentam menos resíduos observados do que a sequência completa. O primeiro resultado, 1A68, possui resíduos não observados, conforme indicado pela contagem modelada menor do monômero:
Ao processar toda a lista e selecionar as entradas com contagens iguais, obtemos a lista final de resultados:
E, finalmente, podemos fazer a análise, isto é, dobrar a sequência e compará-la à geometria experimental:
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
A maioria das estruturas dobradas concorda bastante bem com a estrutura experimental, com um RMSD de 4 Å ou menos:
No geral, os resultados parecem bastante bons. Um RMSD elevado é esperado quando a confiança no dobramento é inferior a 0,75, então os casos discrepantes inesperados possuem confiança superior a 0,75 e um RMSD maior que cerca de 5 Å. Quais seriam eles?
A estrutura 4J4C é a mutação G51P (prolina substituindo glicina na posição 51) de 3EZM. Ambas são dímeros ponta-a-cauda entrelaçados. Podemos usar a informação de “montagem” das biomoléculas para visualizar os dímeros (metade de cada dímero é mostrada em azul e a outra metade em amarelo):
O modelo ESMFold assume que a sequência de entrada corresponde a uma estrutura monomérica, portanto não é surpreendente que ele falhe nesses dímeros entrelaçados.
onde t é a temperatura, que era reduzida em etapas ao longo das iterações, efetivamente implementando um algoritmo de recozimento simulado. Estritamente falando, o recozimento simulado usa energia em vez de adequação, e a temperatura, nesse caso, tem um significado físico. Eles usaram o contraste entre as distribuições de distância entre resíduos previstas pela rede trRosetta e distribuições de fundo médias de todas as proteínas como a adequação, com uma temperatura inicial escalada apropriadamente. Usaram sequências iniciais de 100 resíduos e um número arbitrariamente grande de iterações, 40.000. Vamos seguir esse esquema básico e adaptá-lo conforme necessário para a Wolfram Language.
Sequência aleatória inicial
Sequência aleatória inicial
Usar os códigos de uma letra será conveniente para construir e manipular sequências aleatórias:
Aqui está uma sequência aleatória de 100 resíduos:
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
Dobrar a sequência gera uma BioMolecule, como vimos anteriormente:
Podemos ver que ela não possui elementos de estrutura secundária e não se parece muito com uma proteína que ocorre naturalmente:
Os resíduos foram coloridos começando na extremidade terminal N em azul, passando por verde, amarelo e laranja, até vermelho na extremidade terminal C.
Adequação
Adequação
Embora possamos calcular as distribuições de distância entre resíduos para o dobramento previsto, não temos as distribuições de fundo médias sobre todas as proteínas (por exemplo, do PDB) usadas pelo time de Baker, e portanto não podemos calcular a divergência para usar como adequação.
Contudo, nem tudo está perdido, pois como vimos acima, podemos calcular uma confiança geral do dobramento, o que deve ser apropriados como métrica de adequação. Como era de se esperar, a adequação do dobramento previsto para essa sequência aleatória não é muito alta:
Mutação de resíduos
Mutação de resíduos
A próxima passo que precisamos dar é mutar a sequência. Primeiro, uma posição na sequência é escolhida aleatoriamente, e então o aminoácido nessa posição é substituído por um aminoácido diferente:
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
A valina na posição 96 foi substituída por alanina. Ou seja, criamos a mutação V96A. Qual é o efeito na estrutura?
Interessantemente, o efeito não é totalmente local, e três hélices-α emergiram bem separadas da posição da mutação (a pequena hélice vermelha). Isso leva a um aumento ou uma diminuição da adequação geral?
Otimização por recozimento simulado
Otimização por recozimento simulado
A adequação, ou seja, a confiança na previsão, diminuiu ligeiramente. O critério de Metrópolis para aceitar a mutação é calculado como:
O teste de aceitação é:
Portanto, essa mudança, com sua pequena queda na adequação, seria aceita.
Podemos reunir o código anterior em uma função para otimização da sequência. O serviço ESMAtlas limita o número de chamadas à API que um usuário pode fazer em um determinado período de tempo, mas os detalhes não são divulgados. Um mecanismo de pausa foi incorporado ao código para lidar com essa limitação imposta pelo serviço. Também incluímos um monitor de progresso porque as chamadas à API podem ser lentas dependendo de quantos outros usuários estão utilizando o serviço:
Este é um exemplo da exibição do monitor de progresso:
Para manter este exercício como uma prova de conceito gerenciável, vamos usar apenas 1.000 iterações:
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
Resultados da Otimização
Resultados da Otimização
Isso ficou realmente muito bom! Existem estruturas no PDB com uma sequência semelhante?
>TR:A0A106BVQ6 A0A106BVQ6_THIDE 3-isopropylmalate dehydratase large subunit
OS=Thiobacillus denitrificans OX=36861 GN=leuC PE=3 SV=1
Length=467
Score = 35.0 bits (79), Expect = 9.7
Identities = 17/45 (38%), Positives = 23/45 (51%), Gaps = 0/45 (0%)
Query 2 DYVILRPYYSQDPSIDSSNFWWCGFHGATQDVFHRRIFINATKTD 46
DYV RPY + + D + WW H VF R + ++ATK D
Sbjct 242 DYVKGRPYSPKGAAWDKAVAWWNTLHSDADAVFDRVVELDATKID 286
O que mais podemos aprender com a otimização? Veja como a adequação melhorou ao longo da otimização:
Uma grande fração das iterações não alterou a sequência:
E aqui está como a mudança na adequação evoluiu (os zeros foram omitidos):
Aqui estão os locais onde ocorreram mutações ao longo da otimização:
E aqui está a distribuição de frequência por posição de resíduo:
Doze posições de resíduos (6, 8, 46, 53, 62, 64, 69, 71, 82, 83, 96, 98) não foram modificadas. Ou não foram selecionadas ou as mudanças foram deletérias e não passaram pelo critério de Metrópolis. A melhor solução seria usar mais iterações (Baker usou 40.000).
Como evoluiu o conteúdo de aminoácidos, e qual é a distribuição final?
Isoleucina (I), arginina (R) e treonina (T) são os aminoácidos mais frequentes na última sequência, e metionina (M) foi completamente eliminada.
Como evoluiu a geometria do dobramento? Vamos pegar 10 exemplos de uma progressão geométrica ao longo das iterações e dobrá-los:
Plotar o RMSD do alinhamento dará uma ideia geral da similaridade estrutural par a par da amostra:
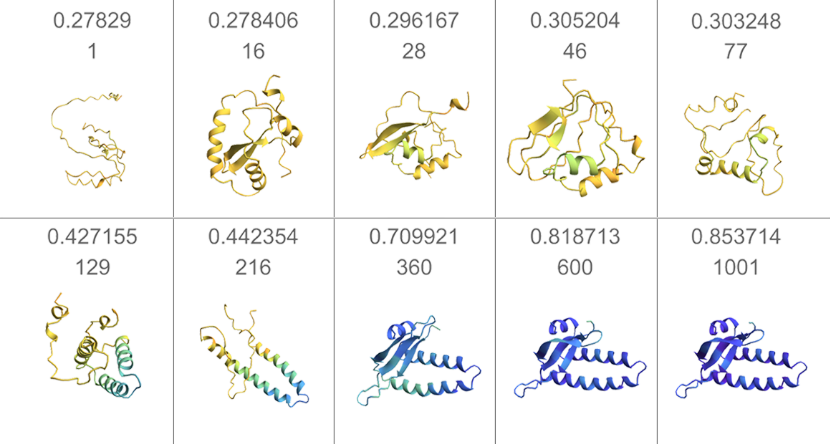
Agora, vamos observar as estruturas. Nos gráficos abaixo, os resíduos foram coloridos de acordo com a confiança na previsão. O primeiro número em cada painel é a confiança geral do dobramento, e o segundo número é o passo na iteração:
Quando a confiança geral atinge cerca de 0,7, o dobramento estabiliza.
Outra maneira de avaliar a evolução do dobramento é por meio de mapas de contato entre resíduos. Conforme observado pela equipe de Baker, os mapas são inicialmente difusos e se tornam mais nítidos ao longo da otimização:
Por curiosidade, submetemos manualmente a sequência otimizada ao servidor trRosetta. Aqui estão os dobramentos que foram previstos com o uso de modelos (templates), juntamente com a confiança geral:
O modelo trRosetta fornece uma confiança na posição atômica em uma escala de 0 a 100, e a confiança geral para cada dobramento não é muito alta.
O relatório de dobramento incluiu as seguintes observações:
◼
A confiança do modelo é muito baixa. Ele foi construído com base em dobramento de novo, guiado por restrições de aprendizado profundo.
◼
Este é um dobramento de sequência única com o trRosettaX, pois não foram detectadas homologias significativas de sequência (no uniclust30_2018_08).
Como eles se comparam à nossa estrutura otimizada prevista pelo ESMAtlas? Não muito de perto, com base no RMSD de alinhamento:
Quanto é suficiente? Então, quantas iterações são suficientes para obter resultados úteis? Mesmo com os computadores pessoais rápidos de hoje e velocidades de internet elevadas, pode levar horas para evoluir uma sequência utilizando o serviço de API. Como vimos acima, 1.000 iterações não são suficientes para amostrar todas as 100 posições de resíduos sequer uma vez, muito menos repetidamente, a fim de encontrar um aminoácido ideal para cada uma.
5.000 Iterações
5.000 Iterações
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
Essa iteração não é meramente uma extensão da anterior, embora ambas tenham começado com a mesma sequência aleatória inicial e o mesmo estado aleatório. Isso acontece porque a meia-vida do decaimento da temperatura é mais longa, permitindo que essa iteração se desvie assim que o critério de Metrópolis gera um resultado diferente. Esse fato se torna evidente ao comparar a adequação das duas iterações:
A sequência final otimizada não guarda semelhança com a da iteração mais curta:
A distribuição de aminoácidos também é bem diferente. Mais notavelmente, vários aminoácidos não estão mais presentes: fenilalanina (F), histidina (H), prolina (P) e triptofano (W):
E qual é o dobramento dessa sequência?
É toda uma longa hélice-α! Considerando que não há resíduos de prolina, esse resultado não é surpreendente. A prolina contém um anel que restringe a rotação em torno do ângulo ϕ, geralmente causando uma torção na cadeia principal naquela posição. Assim, a ausência de resíduos de prolina significa ausência de voltas:
Os gráficos abaixo mostram que a topologia geral do dobramento final é alcançada relativamente cedo, por volta de 40% do caminho durante a iteração, quando a confiança está em torno de 0,75 — como também vimos na iteração mais curta:
10.000 Iterações
10.000 Iterações
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
A evolução da adequação para as três iterações é mostrada abaixo. As iterações com 5.000 e 10.000 passos produziram sequências com confiança muito alta, mas ainda assim não convergiram para uma confiança máxima, como mostrado no detalhe ampliado:
Embora a amostragem das posições de resíduos seja aproximadamente duas vezes maior que a da iteração de 5.000 passos, ela é mais difusa:
Além disso, apenas 15% das posições de resíduos experimentaram todos os aminoácidos pelo menos uma vez (colunas totalmente verdes no gráfico abaixo), e nenhum dos aminoácidos apareceu ao menos uma vez em todas as posições de resíduos (linhas totalmente verdes — somente a alanina chegou perto). Portanto, ir até 20.000 ou mesmo 40.000 passos (como fez Baker) pode ser necessário para um recozimento adequado:
Mais uma vez vemos a perda de vários aminoácidos, e notavelmente a prolina está entre os ausentes:
A sequência final é:
Mais um dobramento totalmente helicoidal-α, como previsto pela ausência completa de prolina. Quão semelhantes são as duas sequências?
Há alguma semelhança entre as duas sequências, mas não é muito alta. Podemos descobrir por que uma sequência sem prolina é o resultado dessa otimização?
O curioso caso da prolina Uma hipótese seria que, uma vez ausente, é difícil restaurar a prolina. A primeira sequência sem prolina aparece no passo 2602:
Qual é a probabilidade de substituição bem-sucedida por prolina em cada posição de resíduo? Para calcular essas probabilidades, precisamos da adequação (confiança geral do dobramento) da sequência sem prolina e de cada uma das sequências substituídas com prolina:
Também precisamos da temperatura naquele passo:
E, finalmente, das probabilidades:
Vemos que uma grande fração das posições de resíduos tem probabilidade muito baixa, mas ainda há um número considerável com probabilidade 1 — e, de fato, a prolina reaparece em um passo posterior, apenas para ser novamente eliminada. O último passo a perder uma prolina é o 5885:
Calcular as probabilidades de restaurar a prolina a partir desse ponto nas iterações segue os mesmos passos:
Portanto, tornou-se muito mais difícil restaurar a prolina na sequência, resultando em uma estrutura que se dobra inteiramente em forma de hélice-α.
Uma Melhoria de Peso Nem todas as posições de resíduos são criadas iguais, e quando se trata de predição de estrutura, algumas são melhor caracterizadas do que outras. Já que estamos fazendo design por otimização, será que poderíamos melhorar o processo ao mutar preferencialmente as posições de resíduos com menor confiança na predição? Ou seja, dar mais atenção às regiões menos bem definidas.
Usamos a confiança por resíduo para aplicar cores às sequências dobradas, e podemos usar essa mesma confiança por resíduo para ponderar a seleção das posições de resíduos durante a mutação.
Aqui está uma função de mutação refatorada que pode receber opcionalmente um conjunto de pesos para as posições de resíduos:
Usando a sequência otimizada da execução de 1.000 iterações como entrada, aqui está uma mutação sem pesos:
Os pesos baseados em confiança são calculados com:
E aqui está a mutação com esses pesos, começando, é claro, do mesmo estado aleatório:
Podemos adicionar uma opção à função sequenceSimulatedAnnealing para usar os pesos baseados em confiança (as mudanças no código estão destacadas em azul):
Utilize a seguinte entrada — estilizada com fundo marrom para fácil reconhecimento — para importar os resultados originais do autor referentes à entrada acima:
A evolução temporal da adequação da otimização ponderada é aproximadamente a mesma da não ponderada. Não é imediatamente evidente se a diferença na adequação final é significativa:
Surpreendentemente, bem menos mutações atenderam ao critério de Metrópolis:
E isso provavelmente explica a menor adequação final. Há uma indicação de mutações mais frequentes no terminal C da sequência (resíduo 100), como mostrado no gráfico à direita. Isso se deve à confiança tipicamente mais baixa nas geometrias dos resíduos nas extremidades da sequência. Em uma outra otimização com 10.000 passos, isso ficou ainda mais evidente:
Quase não há similaridade entre as duas sequências finais:
E, felizmente, a sequência dobrada apresenta uma topologia diferente:
Mais uma vez, os bancos de dados públicos de proteínas não contêm sequências similares:
Quatro ocorrências foram encontradas no banco de dados UniProt, sendo a melhor — embora ainda não muito boa, com E-score = 3.4:
>TR:A0A8J3MJ45 A0A8J3MJ45_9ACTN Hydrolase OS=Catellatospora sp. TT07R-123 OX=2733863
GN=Cs7R123_19000 PE=4 SV=1
Length=252
Score = 36.2 bits (82), Expect = 3.4
Identities = 21/67 (31%), Positives = 33/67 (49%), Gaps = 10/67 (15%)
Query 26 MVTEIGF----LLGVWETTGSWESVLLECKIGCDNIDH------CGLIGSGSEASLSVAF 75
+V+ IGF LL WE TG ++++L ++GC D CG++ E +L +
Sbjct 152 VVSNIGFDIRPLLDAWELTGLCDAIVLSYEVGCIKPDQKIFLRACGMLAVDPERTLMIGD 211
Query 76 KTADTNA 82
AD A
Sbjct 212 TPADAGA 218
Resumo Então, o que aprendemos nessa expedição computacional? Acho que, em primeiro lugar, foi surpreendente como pouco código foi necessário. Criamos algumas funções simples de uma linha (confidence, acceptableSequenceQ, randomSequence, residueConfidence, mutate) e apenas uma função mais robusta (sequenceSimulatedAnnealing). Todo o resto que precisávamos já estava embutido na Wolfram Language e simplesmente funcionou.
A capacidade de começar com uma sequência de códigos de aminoácidos (estrutura primária) e, em um único passo, obter uma estrutura tridimensional realista de proteína (estrutura terciária) é absolutamente impressionante e profundamente satisfatória. O surgimento dos LLMs é digno de um Prêmio Nobel — e o fato de podermos subir facilmente sobre os ombros desses gigantes é de tirar o fôlego.
Também aprendemos que os dados experimentais podem ser difíceis de usar. Fazer boa ciência exige atenção aos detalhes e o hábito constante de perguntar por que um determinado resultado foi obtido. Ao longo do processo, propusemos hipóteses e as testamos.
Apenas arranhamos a superfície da biologia computacional, e a Wolfram Language vai nos permitir ir muito mais longe.
Ideias para Exploração Futura Um campo promissor seria correlacionar as propriedades dos aminoácidos com os dobramentos otimizados. Onde estão localizados tridimensionalmente os resíduos polares e apolares? E os resíduos carregados, como arginina, histidina, aspartato e glutamato?
Qual é o efeito de aumentar ou diminuir a taxa de resfriamento? Definimos a meia-vida da temperatura como 1/8 do número de iterações, conforme utilizado pelo grupo de Baker. No entanto, usamos um protocolo contínuo, enquanto eles usaram um protocolo em etapas.
Muitas proteínas contêm pontes de dissulfeto entre resíduos de cisteína. Como essa característica poderia ser incorporada na geração aleatória de sequências e nas mutações subsequentes? O ESMAtlas consegue dobrar sequências com essa restrição topológica?
Que outros objetivos de otimização poderiam ser utilizados? Nós otimizamos a confiança do dobramento. Como poderíamos otimizar para uma forma específica ou uma combinação de hélices e folhas? Como otimizar o sítio ativo de uma enzima ou o bolso de ligação de um receptor?
Initialization
chainResidueAtom
chainResidueAtom
BioMoleculeAlign
BioMoleculeAlign