 |  |  |
Analisando ataques de extração (destilação) de LLMs: clustering latente e detecção de anomalias baseada em latência
Analisando ataques de extração (destilação) de LLMs: clustering latente e detecção de anomalias baseada em latência
por Ahmed Elbanna
Inspirado pela acusação da OpenAI de que a DeepSeek estaria realizado a destilação de seus modelos, este trabalho investiga a mecânica dos ataques de destilação de Large Language Models (LLMs), analisando como atacantes extraem sistematicamente as capacidades de raciocínio subjacentes de modelos de fronteira. Por meio da análise sistemática das respostas da API, este notebook expõe rastros de extração, como intervalos previsíveis entre consultas e frequências elevadas de marcadores de raciocínio. Ao final, demonstra como mecanismos de defesa baseados em tempo podem revelar tentativas automatizadas de coleta massiva de dados.
No repositório do GitHub, é possível encontrar o código em Python utilizado para criar e organizar o arquivo de dados de prompts, dividido em cinco categorias: abstract (280), code_simple (280), commonsense (280), logic_chain (380), e math_basic (380). Os dados foram derivados do conjunto gsm8k e de templates com níveis de dificuldade fácil, médio e difícil..
Em seguida, utilizei esse conjunto de prompts para coletar 1600 respostas: 1200 prompts no gpt-40 e 400 prompts no gpt-4o-mini. Isso permitiu criar o arquivo responses_openai.csv, utilizado na análise.
Segue a quantidade de respostas coletadas de cada modelo. Os intervalos entre chamadas da API foram fixos para o gpt-4o-mini, enquanto para o gpt-4o foi utilizado um intervalo aleatório uniforme entre 10 e 25 segundos, a fim de reduzir o tempo total de coleta.
Tabular


In[]:=
data=Import["\\\\wsl.localhost\\Ubuntu-22.04\\home\\ahmedco31\\llm-distillation-analysis\\data\\responses_combined.csv","Tabular"]
Out[]=
Tabular
In[]:=
responses=Normal[data[All,"response"]];wordCounts=Length[StringSplit[#]]&/@responses;
Extração de categorias e agrupamento das contagens de palavras
In[]:=
hist=HistogramwordCounts,;groupedData=GroupBy[Transpose[{Normal[data[All,"category"]],wordCounts}],First->Last];box=BoxWhiskerChartValues[groupedData],{"Outliers",{"MedianMarker",1,Directive[Thick,White]}},;GraphicsRow{hist,box},
Out[]=
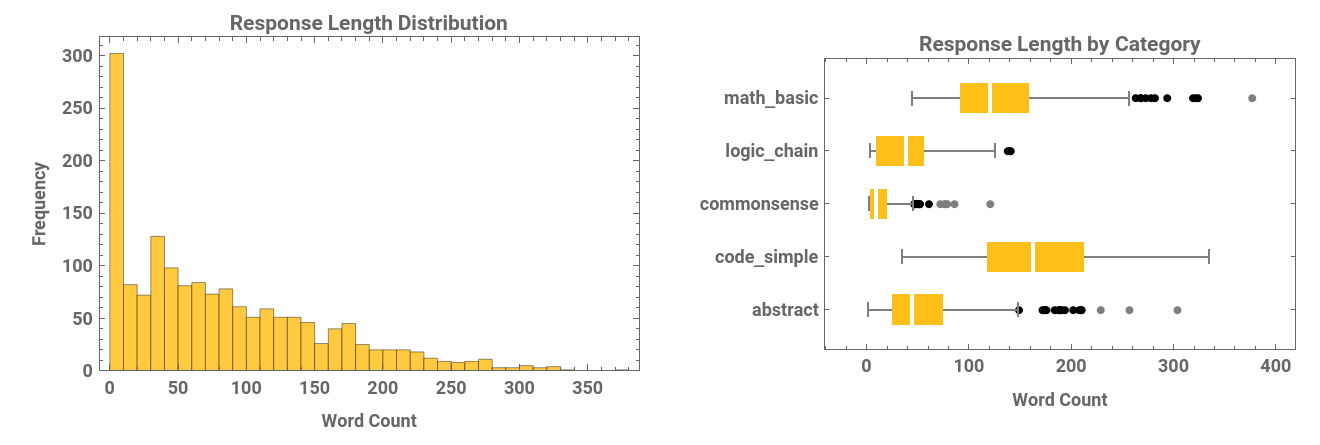
A distribuição fortemente assimétrica à direita no comprimento das respostas é característica de um conjunto de consultas diversificado, cujo objetivo é obter ampla cobertura de domínios — comportamento esperado em processos de destilação. O boxplot mostra como a contagem de palavras se distribui entre as diferentes categorias.
Detecção de padrões de raciocínio
Detecção de padrões de raciocínio
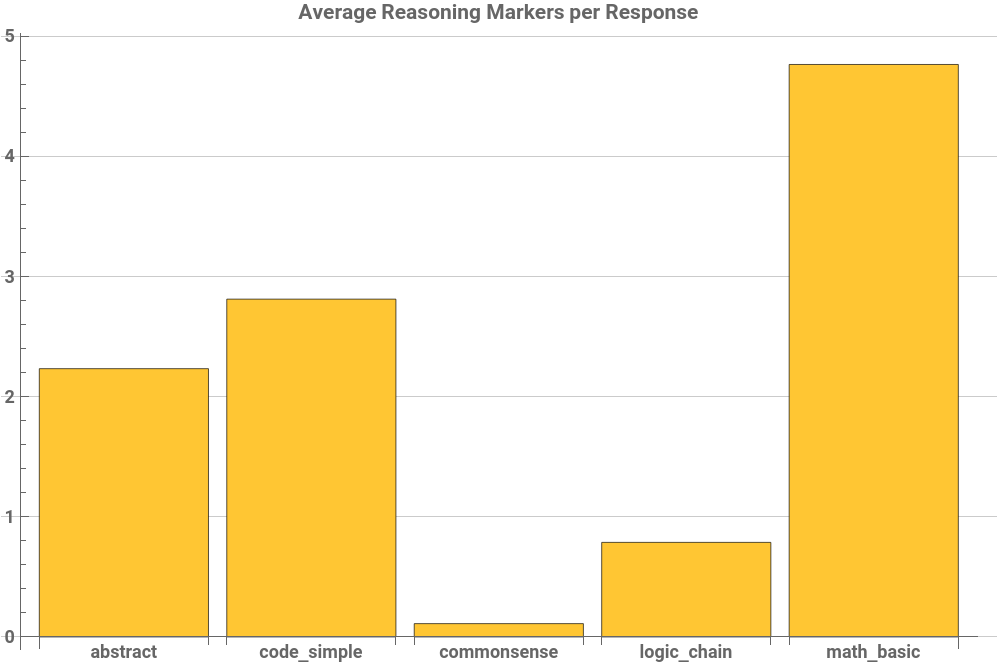
Destilar o processo de raciocínio passo a passo de um modelo — conhecido como Chain-of-Thought (CoT) — é extremamente desejável para um atacante, pois permite extrair não apenas a resposta final, mas também a lógica subjacente e a metodologia de resolução de problemas do modelo alvo. Ao monitorar esses marcadores, os provedores de API podem construir sistemas de detecção de anomalias capazes de identificar consultas sistemáticas projetadas para provocar essas cadeias de raciocínio, que são computacionalmente caras. Esse tipo de comportamento é um forte indício de que um ataque de extração de modelo está em andamento.
O gráfico de barras abaixo mostra a contagem média de marcadores de raciocínio (como “primeiro”, “depois”, “portanto”, “passo a passo”) por resposta, agrupada por categoria. Observa-se uma alta incidência desses marcadores nas consultas das categorias: “math_basic”, “code_simple” e “abstract”.
Definição dos marcadores e da função de contagem
In[]:=
reasoningMarkers={RegularExpression["\\b(first|second|third|finally|therefore|thus|hence)\\b"],RegularExpression["\\b(step \\d+|step-by-step)\\b"],RegularExpression["\\b(because|since|given that)\\b"],RegularExpression["\\d+[\\.\\)]\\s"]};countMarkers[text_String]:=Total[StringCount[text,reasoningMarkers,IgnoreCase->True]];countMarkers[_]:=0;
Adição das contagens aos dados
In[]:=
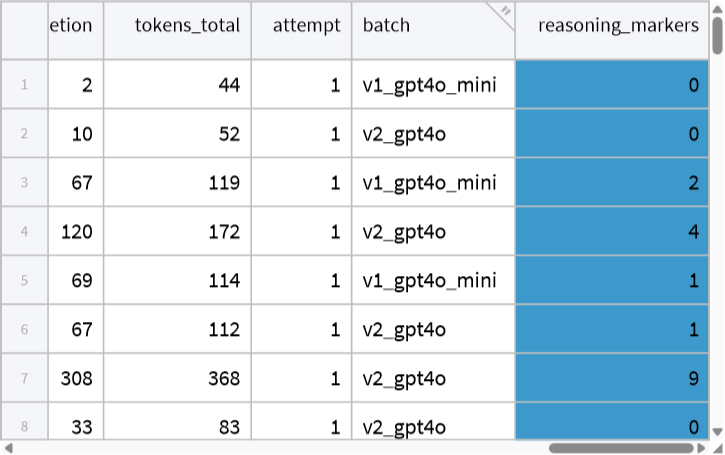
dataWithMarkers=InsertColumns[data,"reasoning_markers"->TabularColumn[countMarkers/@Normal[data[All,"response"]]]];Tabular[dataWithMarkers,Background-><|"ColumnRules"->{"reasoning_markers"->}|>,ImageSize->Medium]

Out[]=
In[]:=
reasoningByCategory=Query[GroupBy["category"],<|"mean"->(Mean),"std"->(If[Length[#]>1,StandardDeviation[#],0.]&),"count"->Length|>,"reasoning_markers"][dataWithMarkers];BarChartQuery[All,"mean"]@reasoningByCategory,
Out[]=
In[]:=
Dataset@reasoningByCategory
Out[]=

Análise de padrões de consulta
Análise de padrões de consulta
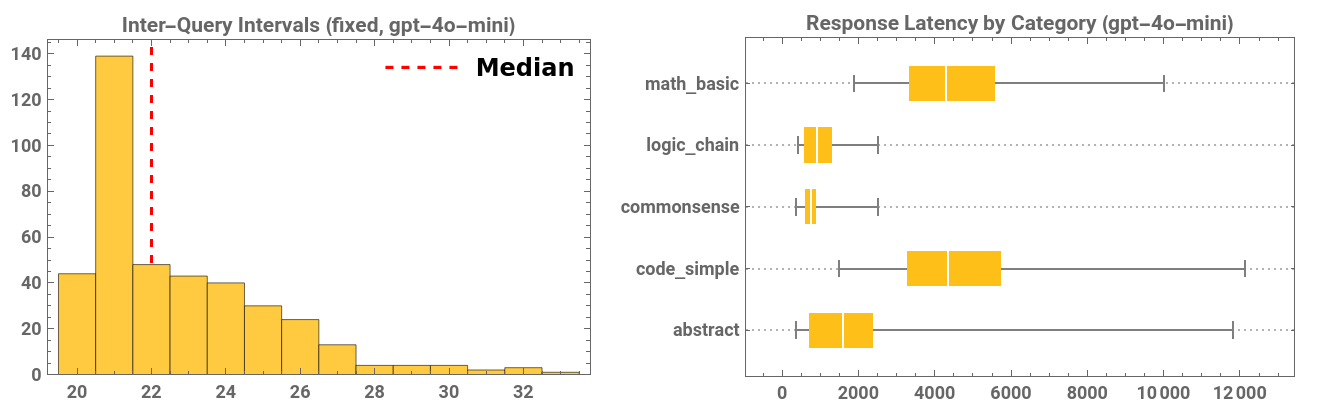
Agora fica claro por que atacantes costumam inserir intervalos aleatórios entre consultas: para imitar o comportamento humano ao interagir com sistemas de IA e, assim, evitar detecção. Quando utilizei um intervalo fixo de 20 segundos entre consultas ao gpt-4o-mini, o histograma dos intervalos entre consultas revelou imediatamente o padrão artificial. A variação na latência das respostas do servidor cria a assimetria observada no histograma. O boxplot mostra que a latência de resposta da API está fundamentalmente associada à categoria da consulta, e não ao intervalo entre consultas.
Por outro lado, no conjunto de dados do gpt-4o, os intervalos foram aleatorizados, o que suavizou o histograma e ocultou esse padrão.
Por outro lado, no conjunto de dados do gpt-4o, os intervalos foram aleatorizados, o que suavizou o histograma e ocultou esse padrão.
In[]:=
dataMini=Select[data,#model=="gpt-4o-mini"&];data4o=Select[data,#model=="gpt-4o"&];
In[]:=
Column@{Dimensions@data4o,Dimensions@dataMini}
Out[]=
{1200,17} |
{400,17} |
Extração dos registros de hora e data, conversão para segundos desde 1900, ordenação e cálculo das diferenças.
In[]:=
intervals=Differences@Sort@N[AbsoluteTime/@Normal[dataMini[All,"timestamp"]]];
In[]:=
medianInterval=Median@intervals;
Latências e sua média. Remoção de outliers decorrentes de erros de conexão.
In[]:=
latencies=DeleteAnomalies@Transpose[{Normal[dataMini[All,"category"]],Normal[dataMini[All,"latency_ms"]]}];
In[]:=
meanLatency=Mean[N@latencies];
Histograma.
In[]:=
lHist=Histogramintervals,;
Latência por categoria: Extração das categorias e agrupamento das latências por categoria
In[]:=
latencyByCategory=GroupBy[latencies,First->Last];
In[]:=
lBox=BoxWhiskerChartValues[latencyByCategory],;
In[]:=
GraphicsRow[{lHist,lBox},ImageSize->660,Spacings->10]
Out[]=
No caso de intervalos aleatórios no gpt-4o
É interessante observar que o gráfico Latência de Resposta por Categoria apresenta a mesma estrutura em ambos os casos. Isso ocorre porque os atacantes não têm controle sobre o tempo necessário para as GPUs da API processarem as consultas.
Clustering de embeddings de prompts
Clustering de embeddings de prompts
Quando prompts são enviados a um Large Language Model (LLM), o sistema converte esses textos em embeddings — grandes vetores numéricos (frequentemente com milhares de dimensões) que representam o “significado” matemático do texto.
Como humanos não conseguem visualizar um espaço de 1000 dimensões, utilizamos o algoritmo UMAP (Uniform Manifold Approximation and Projection). O UMAP é um algoritmo de redução de dimensionalidade que comprime essas milhares de dimensões em apenas duas (os eixos X e Y). O ponto crucial é que o UMAP preserva a estrutura local: se dois prompts possuem significados semelhantes ou provocam comportamentos internos semelhantes no modelo, eles aparecerão no mesmo cluster.
Vamos começar extraindo os valores relevantes dos dados
Esses embeddings podem não ser exatamente os mesmos usados internamente por diferentes LLMs, mas são suficientemente próximos para análise.
Redução por UMAP
Criação de tooltips
Agrupamento de pontos por categoria
O gráfico abaixo demonstra que o LLM trata essas categorias como tarefas computacionais completamente distintas, o que obriga os atacantes a escolher cuidadosamente quais categorias desejam extrair conhecimento.
Observe os clusters compactos e completamente isolados de math_basic (magenta), code_simple (laranja) e knowledge (verde). O modelo não está apenas gerando texto; ele está direcionando essas consultas para regiões altamente especializadas e distintas do seu “cérebro”, isto é, do seu espaço latente.
Curiosamente, os prompts abstract (azul) e logic_chain (vermelho) aparecem divididos em vários pequenos subclusters espalhados pelas bordas. Isso indica que “abstract” não corresponde a um único comportamento dentro do LLM; ao contrário, ele aciona diversos caminhos semânticos internos diferentes.
Quando uma empresa (como a DeepSeek) tenta destilar um modelo de fronteira (como os da OpenAI), ela não busca apenas dados aleatórios. É necessário mapear e extrair sistematicamente toda a paisagem semântica do modelo. Se um atacante consultasse apenas o cluster verde (commonsense), o modelo estudante clonado resultante seria completamente incapaz de escrever código ou resolver problemas matemáticos.
Defesa em nível de infraestrutura: detecção de anomalias baseada em tempo
Defesa em nível de infraestrutura: detecção de anomalias baseada em tempo
Gráfico de latência versus número total de tokens, com anomalias destacadas por Isolation Forest. Normalmente, quanto maior a complexidade do prompt, maior a latência, o que explica a tendência aproximadamente linear observada nos dados. Ter pontos fora da tendência — como pontos com poucos tokens e alta latência no canto superior esquerdo, ou muitos tokens e alta latência no canto superior direito — indica um comportamento incomum que merece verificação. Atacantes não conseguem facilmente falsificar a matemática de como as GPUs geram tokens, o que torna isso uma boa ferramenta de defesa contra extração de modelos.
CITE ESTE NOTEBOOK
CITE ESTE NOTEBOOK
Analyzing LLM extraction (distillation) attacks: latent clustering & latency-based anomaly detection
by Ahmed Elbanna
Wolfram Community, STAFF PICKS, March 10, 2026
https://community.wolfram.com/groups/-/m/t/3656501
by Ahmed Elbanna
Wolfram Community, STAFF PICKS, March 10, 2026
https://community.wolfram.com/groups/-/m/t/3656501