 |  |  |
Uma aventura de dados em Boston, 1929: Análise de corpus histórico de censo
Uma aventura de dados em Boston, 1929: Análise de corpus histórico de censo
por Rory Foulger
Estou escrevendo um romance. É uma obra de ficção histórica. Ao que parece, isso significa que é necessário fazer muita pesquisa sobre como era a vida na década de 1920.
O problema na noite passada era o seguinte: meu personagem se muda para Boston vindo de Chicago e, para dar textura à cidade, é preciso introduzir personagens, edifícios, ruas e assim por diante de uma forma que soe real. O detalhe sobre Boston, especialmente o West End para onde ele vai, é que a área mudou drasticamente nos últimos 100 anos. Houve um grande projeto de revitalização urbana nas décadas de 1950 e 1960 que basicamente demoliu toda a região. Assim, nenhuma das ruas ou edifícios se parece sequer remotamente, hoje, com o que meu personagem veria ao caminhar por ali.
Além disso, o West End era habitado por uma mistura muito específica de pessoas, principalmente italianos e judeus, de modo que, para ser fiel, preciso escolher nomes e profissões para o elenco de apoio a partir de algo mais específico do que a lista dos 100 nomes mais comuns dos Estados Unidos naquele ano.
Mas vamos começar pelos mapas. Ruas são interessantes, e deve haver algo útil em algum lugar.
.........
Ah, sim. Existem muitos mapas.
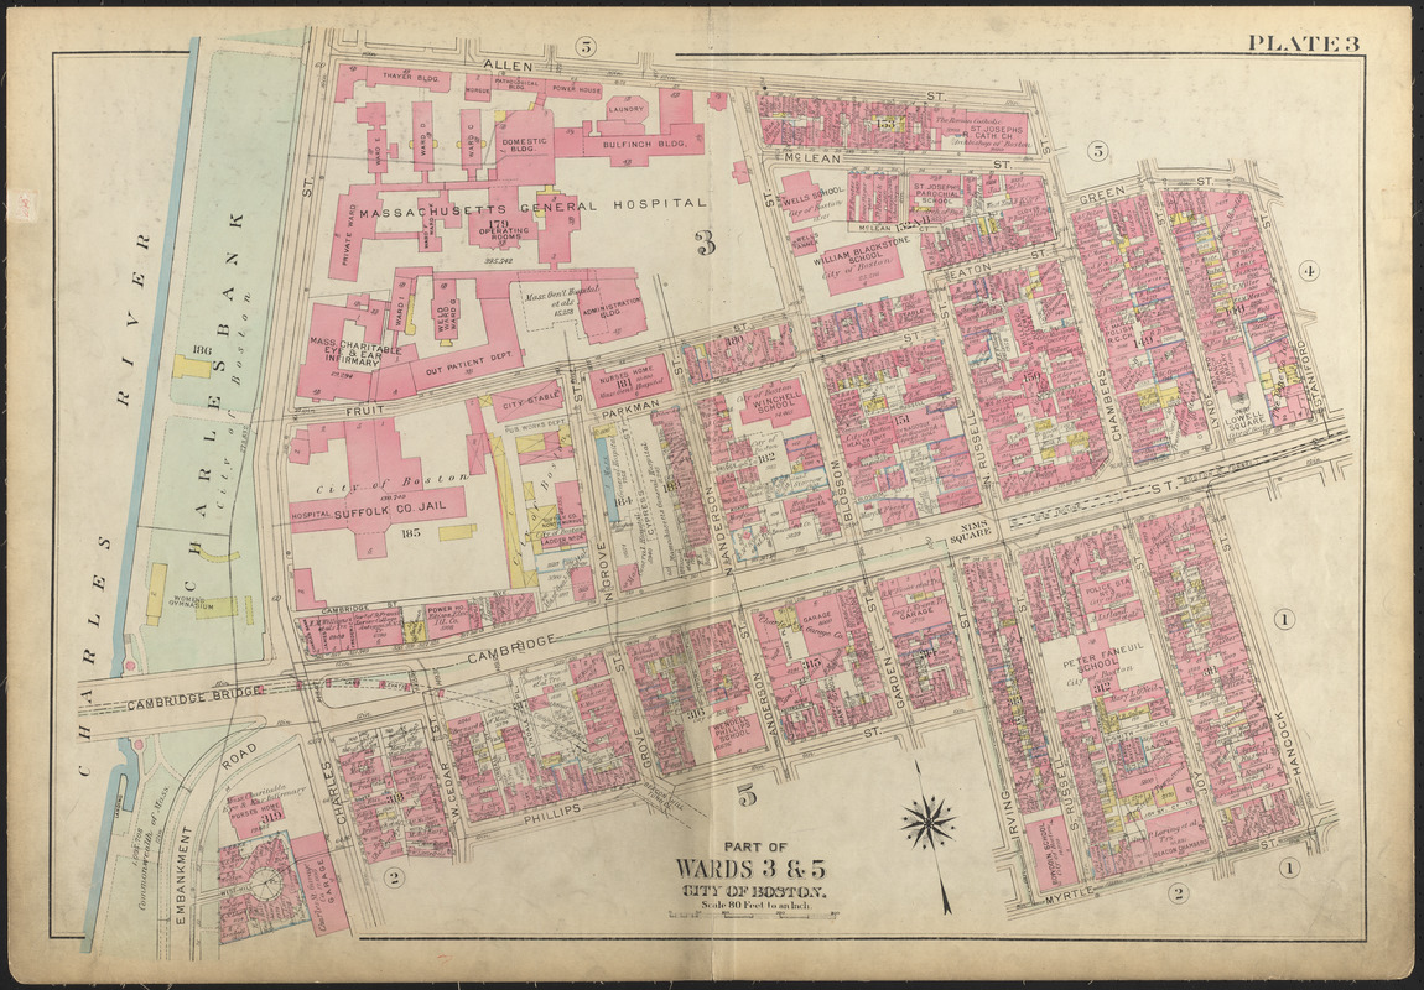
Especificamente este, da edição de 1928 do Atlas da Cidade de Boston, prancha 3. Isso é ótimo!
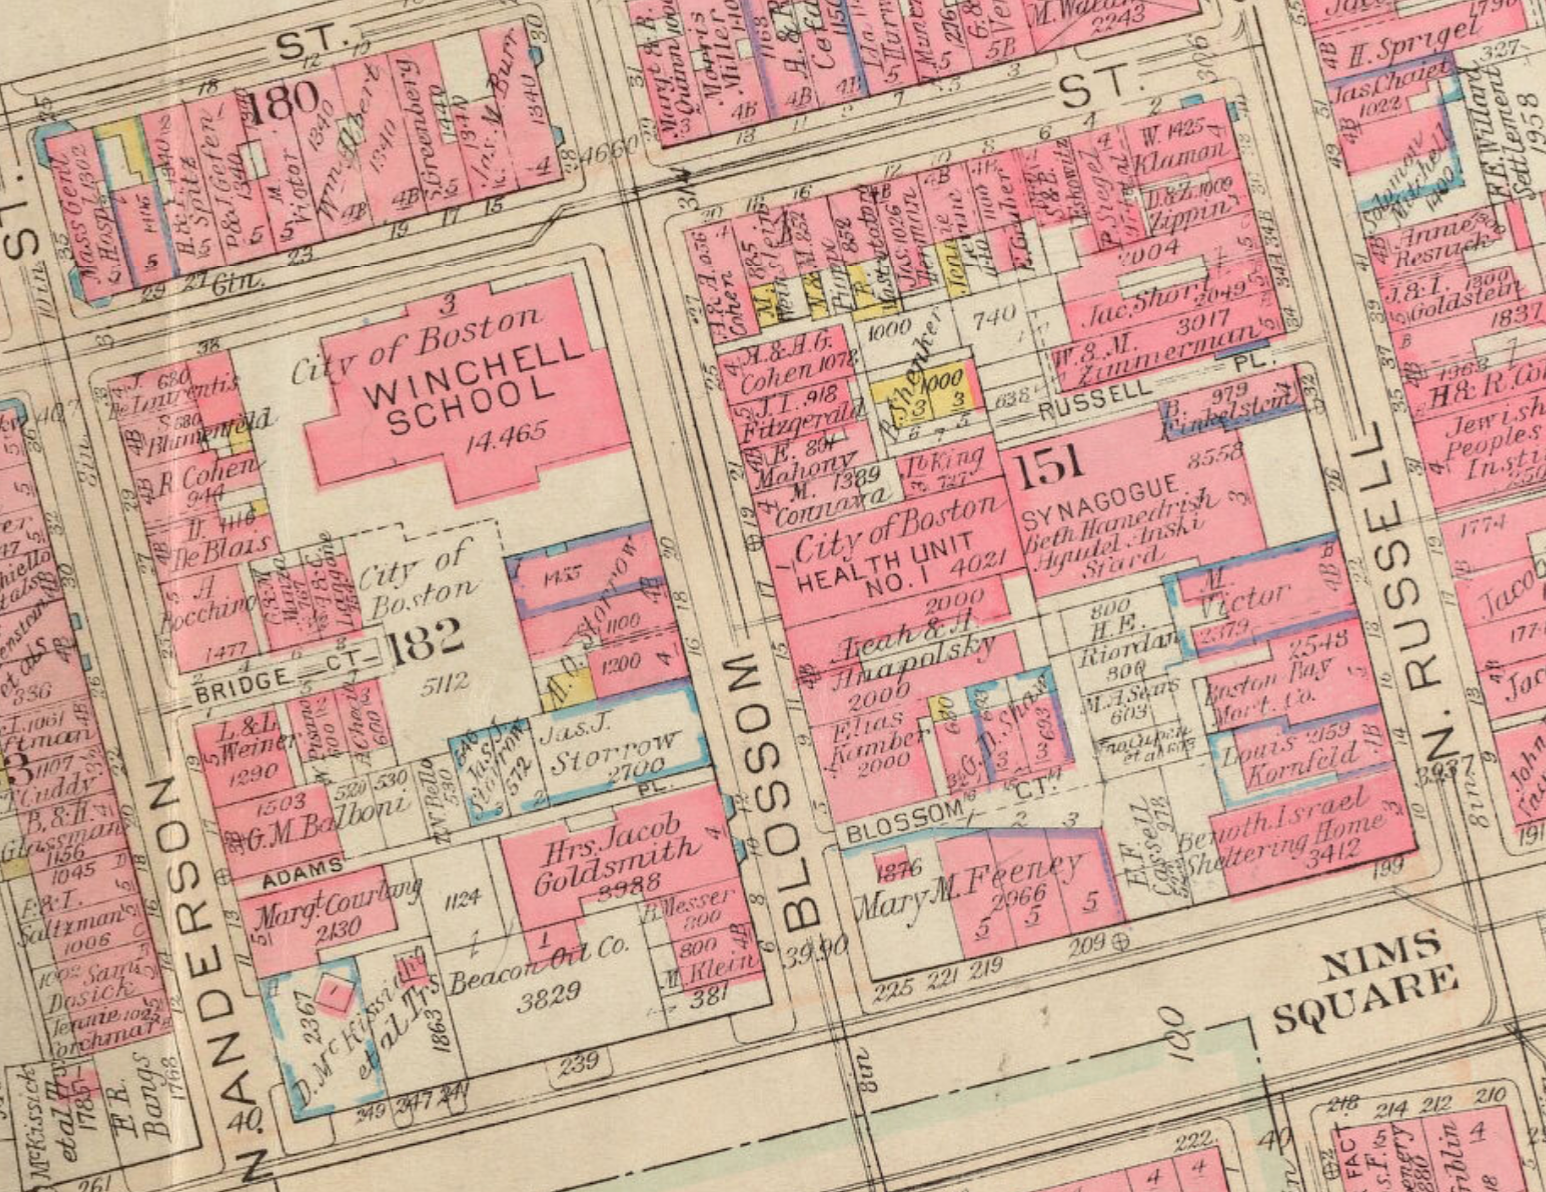
Meu personagem está se mudando para uma pensão logo atrás da sinagoga, exatamente aqui:
Meu personagem está se mudando para uma pensão logo atrás da sinagoga, exatamente aqui:
In[]:=
Em comparação, é assim que a área parece hoje:
In[]:=
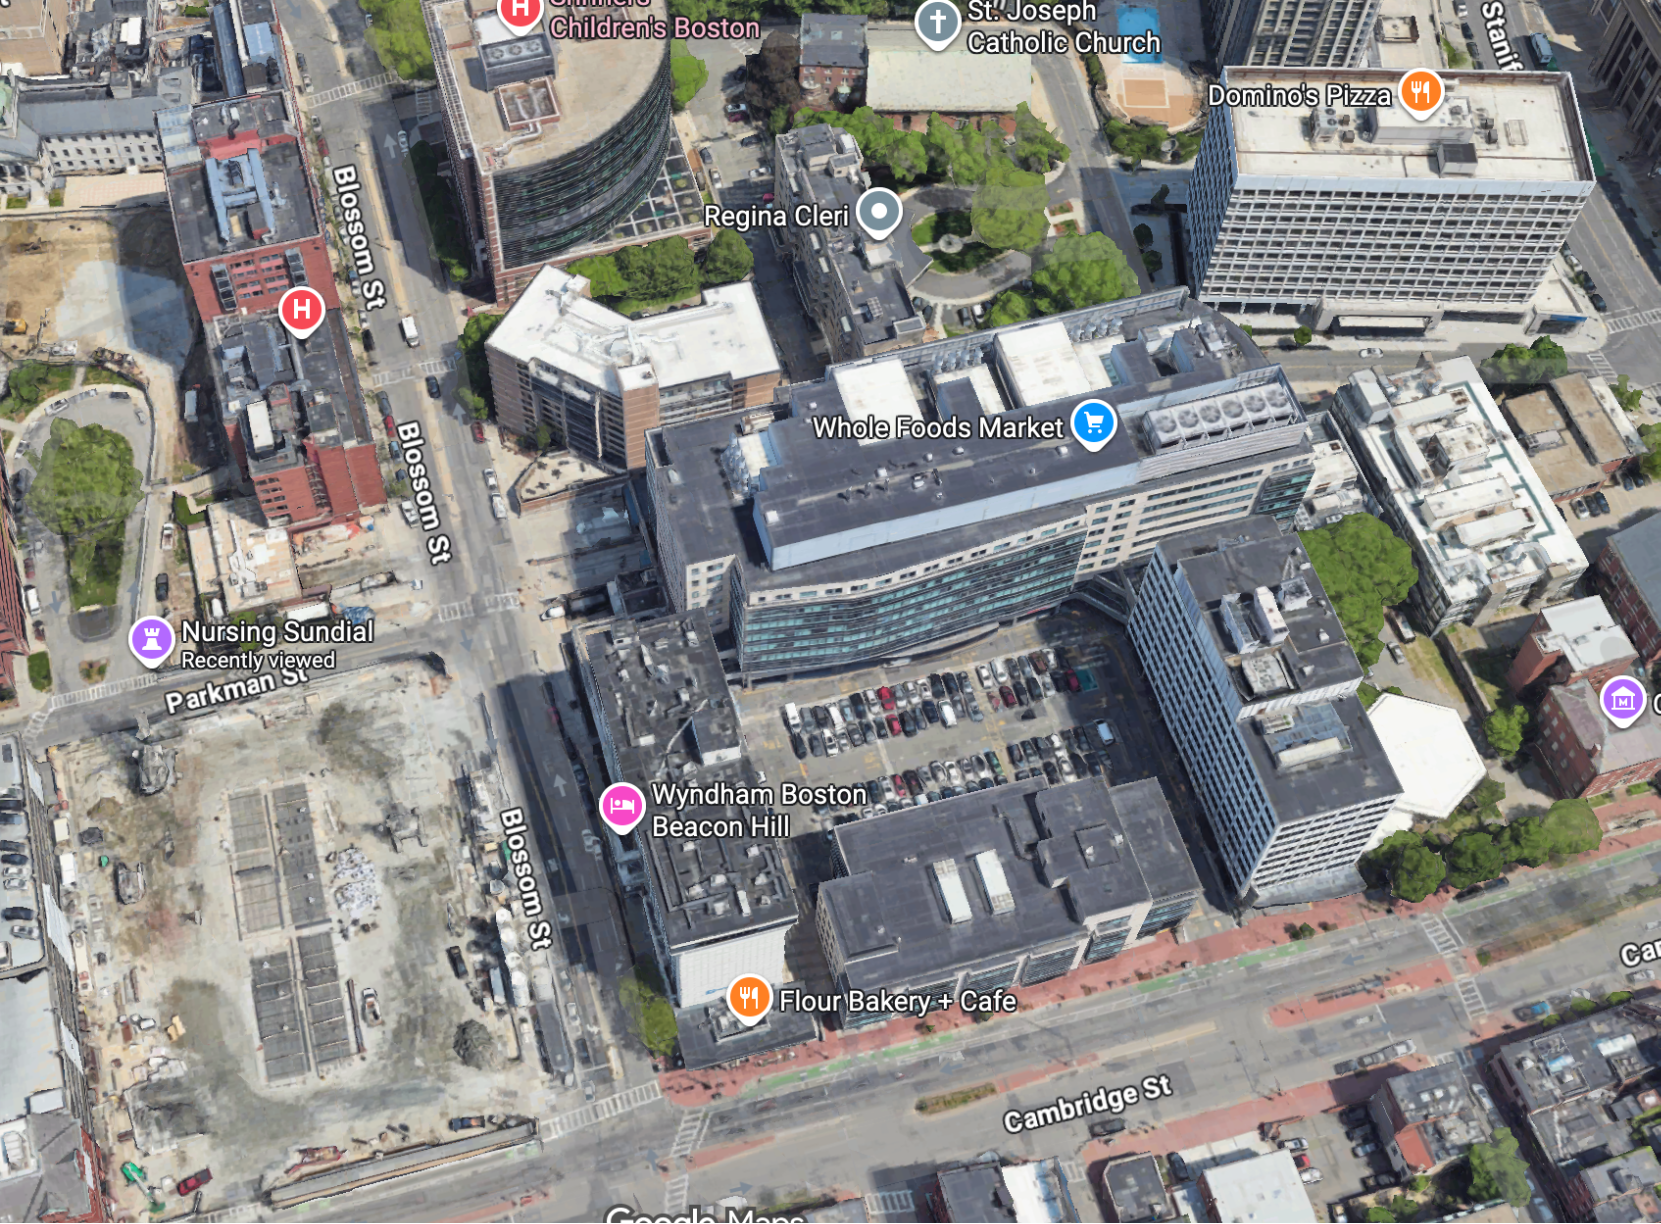
A Russell Street desapareceu, a Blossom Street comporta seis faixas de tráfego, e há um conveniente supermercado onde antes ficavam a sinagoga, uma escola e acomodações para cerca de mil pessoas.
A melhor coisa desses mapas antigos é que o nome do proprietário do edifício está escrito diretamente sobre ele. Isso me deu a ideia revolucionária de verificar se existia algum censo ou lista de moradores daquela época para obter ideias de nomes de personagens.
E, surpreendentemente, não apenas existe uma lista detalhada de todos os moradores de praticamente todos os anos desde 1868, como, antes da década de 1980, essas publicações eram organizadas por distritos geográficos, o que significa que posso abrir especificamente a parte correspondente às pessoas que viviam na área mostrada no mapa acima.
E, surpreendentemente, não apenas existe uma lista detalhada de todos os moradores de praticamente todos os anos desde 1868, como, antes da década de 1980, essas publicações eram organizadas por distritos geográficos, o que significa que posso abrir especificamente a parte correspondente às pessoas que viviam na área mostrada no mapa acima.
Out[]=
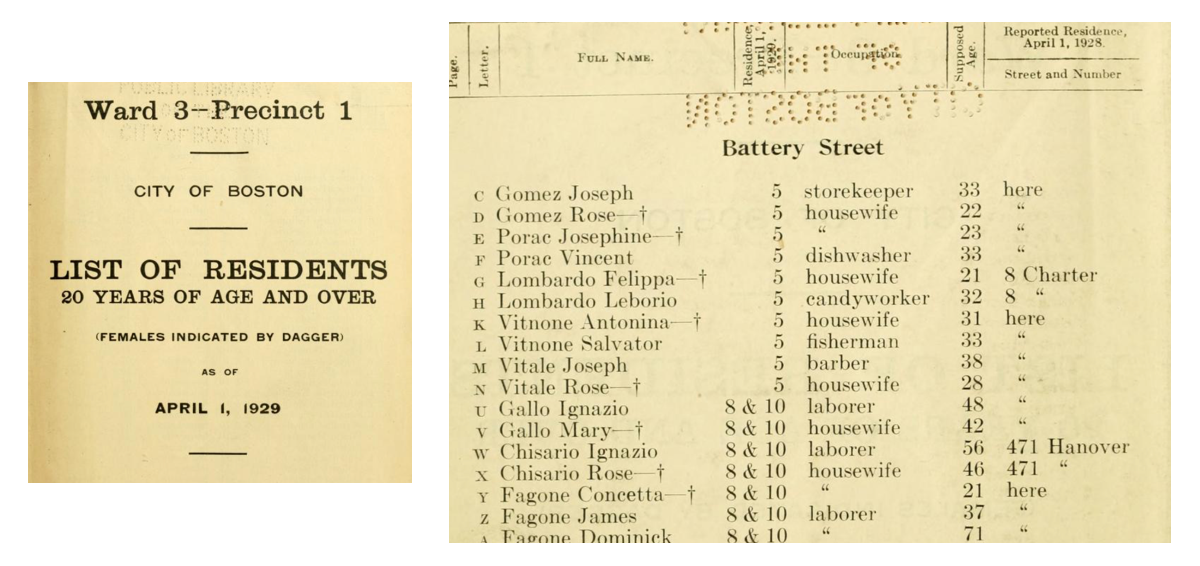
Um verdadeiro tesouro. A lista não apenas inclui o nome de cada pessoa, gênero (mulheres indicadas com um símbolo especial!) e idade, mas também a ocupação, endereço e endereço anterior, caso tenha havido mudança desde o censo anterior.
“Fantástico”, pensei, olhando o relógio e percebendo que já eram onze da noite de uma sexta-feira. Posso ir dormir tranquilo, sabendo que amanhã poderei escolher alguns nomes e finalmente começar a escrever.
Mas, disse a parte do meu cérebro que estudou estatística na faculdade, não é possível simplesmente escolher nomes aleatoriamente. E se eu escolher um nome que aparece apenas uma vez? Ou o mais comum para um personagem incomum? Vou parecer descuidado!
“Tudo bem”, respondi ao meu cérebro, “aposto que conseguimos calcular isso de forma rápida e simples, e então eu vou dormir”.
E assim começou.
23h30: O primeiro obstáculo
23h30: O primeiro obstáculo
A Lista de Moradores está muito bem apresentada no arquivo. O PDF é pesquisável e tem até aquela animação de virar páginas. O problema foram os outros formatos.
O principal obstáculo era que o OCR utilizado para ler o livro não funcionava bem com tabelas. Algumas páginas tinham todos os nomes seguidos dos endereços, depois ocupações, idades e assim por diante. Outras estavam organizadas em linhas. Outras ainda tinham combinações aparentemente aleatórias dessas informações.
O principal obstáculo era que o OCR utilizado para ler o livro não funcionava bem com tabelas. Algumas páginas tinham todos os nomes seguidos dos endereços, depois ocupações, idades e assim por diante. Outras estavam organizadas em linhas. Outras ainda tinham combinações aparentemente aleatórias dessas informações.
In[]:=
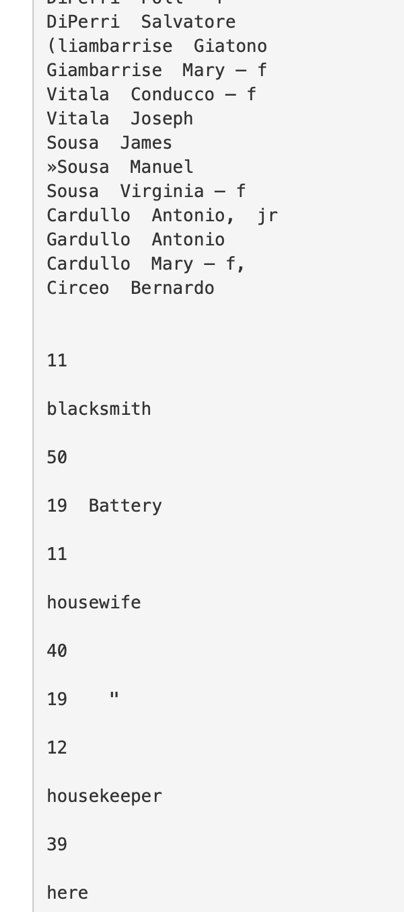
Também estava repleto de pequenos artefatos curiosos, como “(“ no lugar de “G”, “U” no lugar de “li” e explosões de pontuação assustadoras.
Out[]=
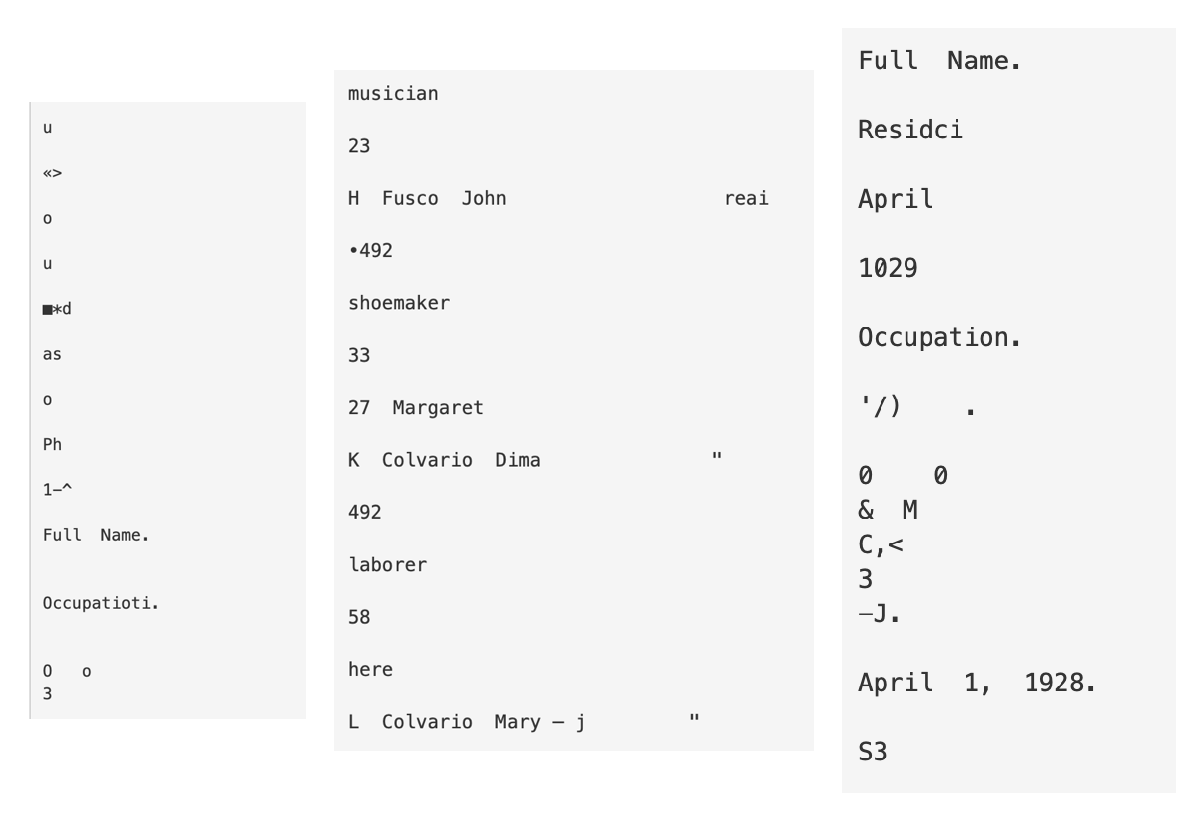
Eu tentei. Fiz uma série de limpezas programáticas para começar, mas havia variáveis demais. Meu sonho de simplesmente jogar um arquivo de texto em um notebook e gerar uma WordCloud morreu ali. Decidi fechar o laptop.
Mas espere, disse meu cérebro, você já gastou uma hora nisso, não pode simplesmente parar!
Já é quase meia-noite, respondi ao meu cérebro, e essa não é uma boa forma de passar a noite.
Você vai fazer mesmo assim, não vai? perguntou meu cérebro, fazendo bico.
E assim seguimos em frente.
Mas espere, disse meu cérebro, você já gastou uma hora nisso, não pode simplesmente parar!
Já é quase meia-noite, respondi ao meu cérebro, e essa não é uma boa forma de passar a noite.
Você vai fazer mesmo assim, não vai? perguntou meu cérebro, fazendo bico.
E assim seguimos em frente.
4h45: Um conjunto de dados
4h45: Um conjunto de dados
Quando o sol começou a nascer e meu cachorro desistiu de me encarar e passou a roncar como um trem elevado dos anos 1920, eu tinha um conjunto de dados.
Não era grande coisa. Ainda havia muito conteúdo aleatório, e acabei me convencendo a parar na metade de um arquivo com 382.558 linhas.
Mas eu tinha um .rtf relativamente limpo, com todas as ocupações e cerca de metade dos nomes. Finalmente estava pronto para começar a trabalhar com dados de verdade, em vez de apenas me preparar para isso.
Ainda havia alguma limpeza a fazer. Eu precisava separar nomes de ocupações e eliminar uma série de caracteres soltos e espaços em branco. Felizmente, havia uma única constante em todo o texto: os nomes estavam em maiúsculas e as ocupações não.
6h30: A análise
6h30: A análise
E agora, quase sete horas depois, finalmente posso olhar para os nomes. Talvez tivesse sido melhor dormir, mas já avançamos demais.
Nomes
Nomes
Vamos começar pelos primeiros nomes.
Ótimo, há muitas opções! Vamos separá-los por gênero e compará-los com os 100 nomes mais comuns dos Estados Unidos em 1929, só para garantir que eu não passei a noite em claro para descobrir que o West End de Boston é igual ao resto do país.
Obter os 50 nomes masculinos e os 50 femininos mais comuns usando o classificador NameGender
Obter os 50 principais de cada gênero no país inteiro
Criar WordClouds para cada conjunto, com os dados de Boston à esquerda e os dos EUA à direita.
Graças a isso, vejo diferenças bem significativas nas convenções de nomes, mesmo apenas nos 50 principais de cada gênero. Para homens, nomes como Dominic, Arthur, Pasquale e Salvatore aparecem em Boston, mas não no conjunto geral dos EUA. Para mulheres, Mary parece sempre uma escolha segura, mas eu evitaria Betty, Dorothy e Virginia nessa região.
Agora vamos olhar os sobrenomes:
Agora vamos olhar os sobrenomes:
Muitas ótimas opções para meu elenco de personagens!
Ocupações
Ocupações
Parece que os empregos mais comuns nessa parte da cidade são “dona de casa” (provavelmente uma classificação padrão, mesmo quando há outras atividades como lavar roupa para terceiros) e “trabalhador braçal”, que são categorias bastante amplas. Explorando um pouco mais, encontramos ocupações como escriturário, cozinheiro, vendedor, alfaiate, motorista e pintor como próximas mais comuns. Um detalhe importante para Boston é o 20º trabalho mais comum: fabricação de doces. Se quiser ver algo impressionante, vale pesquisar o Great Molasses Flood de 1919, quando um tanque de armazenamento explodiu e inundou o North End com uma “onda” de melaço.
Vamos dar uma olhada rápida nos 10 principais:
É interessante como tantas pessoas se concentram nas duas primeiras ocupações e como rapidamente ocorre a especialização depois disso.
8h25: O resultado
8h25: O resultado
O sol nasceu. O cachorro acordou e está ainda mais confuso do que antes. E minha análise de dados terminou. Agora posso criar um pequeno elenco de personagens. Eu poderia expandir isso — incluir diferenciação por gênero, ajustar probabilidades para nomes comuns ou raros, separar por origem étnica para evitar combinações incoerentes — mas já estou nisso há 10 horas e gostaria de dormir.
Então apresento meu gerador aleatório de personagens para o West End de Boston em 1929!
8h30: Boa noite
8h30: Boa noite
Obrigado por acompanhar esta pequena aventura estatística. Espero que o dia seja excelente e que o cérebro não assuma compromissos por conta própria.
EDIÇÃO: Domingo à noite
EDIÇÃO: Domingo à noite
“Espere”, disse meu cérebro, às 23h30 de domingo. “Você passou toda a sexta-feira à noite fazendo isso, e aposto que havia uma maneira melhor. Que tal passar esta noite forçando os dados a funcionarem?”
.......
Está bem.
O conjunto completo, bruto e não editado manualmente:
.......
Está bem.
O conjunto completo, bruto e não editado manualmente:
Primeiro, uma limpeza básica. Remover excesso de espaços em branco, pontuação e números:
Sabemos, a partir da limpeza manual, que muitas linhas contêm múltiplas ocupações, mas também há ocupações com duas palavras, como “real estate”. Portanto, não podemos simplesmente dividir tudo por palavras. Felizmente, encontrei uma forma relativamente simples de identificar expressões de duas palavras que aparecem junto com expressões de uma palavra:
Queremos protegê-las, então vamos substituí-las por versões com underscore, para que não sejam separadas ao dividir as linhas:
Agora podemos dividir o arquivo em linhas, e cada ocupação (junto com eventuais resíduos) deve ficar isolada:
Sabemos também que ocupações estão sempre em minúsculas, então basta selecionar linhas sem letras maiúsculas. Infelizmente, muitas dessas linhas ainda contêm artefatos, como “ii” no início ou “PR” no final. Então fazemos uma limpeza de strings.
◼
remover códigos de duas letras no início
◼
remover códigos de uma letra no início
◼
remover códigos de duas letras no final
◼
remover códigos de uma letra no final
◼
remover espaços extras no início e no fim
Então, usando essas strings, simplesmente começamos a descartar coisas. Quaisquer linhas muito curtas, quaisquer linhas que contenham letras maiúsculas, quaisquer linhas com mais de 2 palavras (como “this book is a list of things”). Em seguida, garantimos que cada linha contenha apenas letras e espaços, sem caracteres extras aleatórios espalhados. Também decidimos não fragmentar linhas que tenham 2 ou mais palavras, para preservar expressões como “real estate” intactas.
Então agora temos uma longa lista de ocupações potenciais. Infelizmente, como já mencionei algumas vezes, o OCR usado para esse PDF era bastante ruim. Temos um número praticamente infinito de grafias para quase todas as ocupações. Temos algumas duplicadas. Temos algumas sequências aleatórias de letras. Chamo sua atenção para candjworker, candyniaker, housnvife e housewoiker:
Vamos fazer algumas coisas aqui. Comecemos pelas grafias. A maneira mais fácil de corrigir esse tipo de bagunça é usando EditDistance. Precisamos usar grafias corretas para obter nossa lista de palavras reais e, então, podemos corrigir as que estão escritas incorretamente. Eu selecionei as 200 palavras mais comuns da lista e depois acrescentei mais algumas por garantia:
Capturamos as contagens de todas as palavras atuais da lista e, por exemplo, variants[“housewife”] irá percorrer todas as strings e retornar aquelas dentro de uma distância limite em relação ao termo-alvo. Assim, deve transformar “hoosewife”, “houseAife” etc. em “housewife”, porque estão a apenas 1–2 caracteres de distância.
Em seguida, construímos um conjunto de regras de substituição, aplicamos essas regras a cada string da lista para substituí-la por uma forma canonicalSpellings, e então fazemos novamente a contagem para obter nossa lista.
Adoramos uma correspondência aproximada.
Depois, há várias strings que contêm múltiplas ocupações. Mas não queremos reduzir tudo a uma única palavra. Queremos garantir que não vamos dividir “real estate” em “real” e “estate”.
Então podemos dizer que qualquer coisa que apareça mais de 5 vezes provavelmente é uma ocupação real, e não várias ocupações na mesma linha:
Em seguida (porque já verifiquei isso antes), também sei que há algumas que ainda precisam ser separadas após esse processo de limpeza:
Agora temos uma função bem simples em que dividimos a string quando ela precisa ser dividida e não dividimos quando sabemos que é uma ocupação real:
Então fazemos todo o processo, executando a verificação ortográfica e a divisão das linhas de uma só vez:
Mas então... temos muitas profissões muito semelhantes que usam palavras diferentes. Então vamos agrupar algumas pessoas em categorias:
Depois podemos simplesmente substituir ocupações individuais pela respectiva categoria:
E pronto. De repente, e com muito menos trabalho manual, temos uma lista de ocupações.
Curiosamente, ela tem apenas cerca de 6 mil entradas a mais do que eu consegui com um método significativamente mais manual. Mas está definitivamente mais limpa e mais precisa.
Agora obtemos uma versão um pouco mais compacta, que está toda limpa e organizada.
Eu tentei. Mas, se você captura essa linha, é quase impossível não capturar também:
Então é isso que vamos fazer, eu acho!
Os nomes são SIGNIFICATIVAMENTE mais difíceis, porque muitos deles estão escritos incorretamente, frequentemente com pontuação no lugar de letras. Talvez eu volte a isso outro dia, mas agora são 4 da manhã de segunda-feira e eu passei todas as horas que deveria ter dormido neste fim de semana fazendo isso :)
Anexei o arquivo txt completo diretamente do OCR, então fique à vontade para fazer melhor do que eu!
Anexei o arquivo txt completo diretamente do OCR, então fique à vontade para fazer melhor do que eu!
Gerador Atualizado de Nome/Ocupação
Gerador Atualizado de Nome/Ocupação
E agora podemos fazer um gerador de nomes melhor, porque ainda há tempo antes de eu começar meu trabalho de verdade (não fazendo isso na Wolfram) em 4 horas.
Vamos deixar nossos dados mais apresentáveis:
Vamos deixar nossos dados mais apresentáveis:
Seria interessante poder escolher se o personagem tem um nome e uma ocupação comuns ou incomuns, então vamos dividir os conjuntos de dados em 4. Também queremos escolher um gênero:
Agora juntamos tudo em uma função bacana:
E agora uma pequena página de formulário:
E fazer o deploy:
Incrível. Tive um fim de semana realmente excelente, e você?
CITE ESTE NOTEBOOK
CITE ESTE NOTEBOOK
A data adventure in Boston, 1929: historical census corpus analysis
by Rory Foulger
Wolfram Community, STAFF PICKS, April 12, 2026
https://community.wolfram.com/groups/-/m/t/3682277
by Rory Foulger
Wolfram Community, STAFF PICKS, April 12, 2026
https://community.wolfram.com/groups/-/m/t/3682277