Hackathon - Wolfram - Texas Tech
Costa Rica - 2025
Equipo HACKHER:
Costa Rica - 2025
Equipo HACKHER:
Sofía Masís Alvarado , Diana Rodríguez Vargas y Amanda Torres Venegas
In[]:=
GridImage[#,ImageSize->{Automatic,100}]&/@
,
Out[]=
Hackathon Day
Hackathon Day
Problemática
Problemática

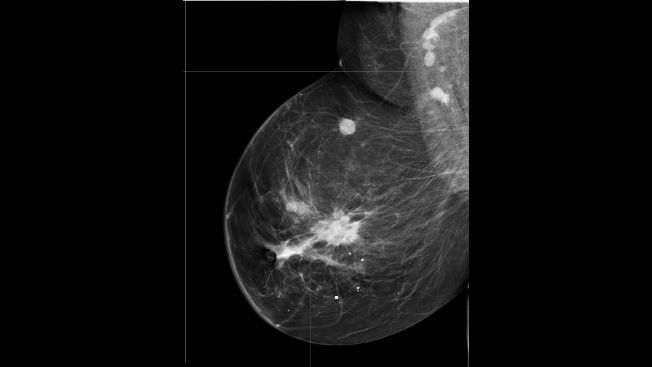
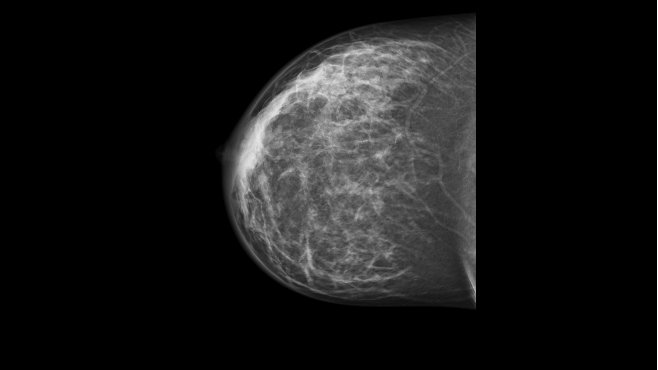
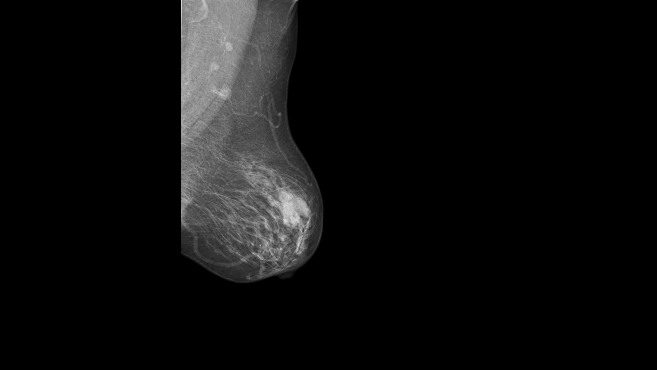
Descarga, preparación e importación de conjuntos de datos
Descarga, preparación e importación de conjuntos de datos
Para manipular los datos, se utilizó un conjunto de funciones. Se empleó la función “Establecer directorio” para definir las ubicaciones donde se guardaría la información y se ejecutarían los programas. Esto permite al sistema leer una serie de archivos importados como listas, un conjunto etiquetado como “ExamImageCancer” y “ExamImageNoCancer”. ¿Cómo funcionan exactamente estos archivos? Mediante las funciones “Manipulate”, “Length” , el dispositivo puede interactuar con la colección completa de imágenes y comprender su significado. De esta manera, simplificamos el proceso de análisis, permitiendo que el ordenador determine automáticamente el significado de cada imagen basándose en los datos almacenados, en lugar de utilizar instrucciones largas y complejas.
Descarga de Datos
Descarga de Datos
Se utilizaron las siguientes bases de datos:
Descarga de Data set 1:
Descarga de Data set 1:
Se utilizaron rutas de archivo para poder descargar los datasets a wolfram
In[]:=
(* Linux and Mac folders with / *)bcidImagesFolder = "/Users/dianarodriguez/Desktop/HACKHER/Mammogram Mastery A Robust Dataset for Breast Cancer Detection and Medical Education";
Esta línea enseña las rutas de archivo completas de cada imagen
In[]:=
(* Linux and Mac folders with / *)bcidImages=FileNames["*jpg",bcidImagesFolder,Infinity]
Out[]=
Descarga de dataset 2:
Descarga de dataset 2:
Se descargan las imagenes de archivo a listas y se les asigna variables
Se chequea la cantidad de imagenes como confirmación de que los archivos se descargaron exitosamente:
Se utiliza la función Manipulate para poder interactuar con ambos datasets BCID, Cancer y No Cancer:
Ahora podemos cargar los datos. Podemos crear un clasificador de IA para los exámenes:
Ahora podemos cargar los datos. Podemos crear un clasificador de IA para los exámenes:
Se utiliza la funcion RandomSample como confirmacion de que se pueda manipular examImagesCancer y No Cancer de manera correcta
Entrenamiento de IA
Entrenamiento de IA
Se modificaron varios detalles del código para mapear e identificar los elementos programados como verdaderos. Al convertir los archivos a escala de grises y reducir su tamaño a 600 píxeles, el software puede utilizar el algoritmo para determinar si la imagen del examen muestra cáncer o no. Una vez finalizado el entrenamiento, se utiliza CloudPut para guardar los datos del modelo de clasificación de cáncer. A continuación, para realizar la prueba, se empleó otro conjunto de datos para comprobar la precisión de la detección con una selección de imágenes de referencia. Junto con Classify, el gráfico circular proporciona una representación estadística de los resultados.
Training data set
Se convierte la escala a gris y se reconvierte el tamaño de la imagen a 600px en 620 y 125 muestras aleatorias respectivamente.
Se confirman la cantidad de imágenes.
Debido a que si tiene un dataset pequeño se decidió usar la técnica de data augmentation para poder compensar la cantidad de imágenes con Cancer a las que no tienen. Esta técnica consiste en crear nuevas imagenes usando la base de datos preexistent por medio de cambio de contraste, rotaciones, cambio de brillo, zoom, entre otros.
Se utilizo aleatoriamente el 40% de examImagesCancer con el fin de igualar la cantidad de imágenes por clase
Se utilizo aleatoriamente el 40% de examImagesCancer con el fin de igualar la cantidad de imágenes por clase
Me aseguro que si se haya usado data augmentation con el 45% de datos de trainingCancerData
Con la función Classify se entrena el algoritmo de machine learning en dos clases Cancer y No Cancer. Al usar ClassPriors se disminuye el desbalance entre clases.
Se sube a WolframCloud la función
Se va a evaluar el AI ML Classifier al usar una imagen que no esta en el training data
Consigue una imagen real de un artículo científico (paper): https://www.mdpi.com/2313-433X/9/5/95
Mammography Datasets for Neural Networks—Survey (Scientific Paper)
https://www.mdpi.com/2313-433X/9/5/95
https://www.mdpi.com/2313-433X/9/5/95
Se va a evaluar imágenes fuera del set de entrenamiento de datos original (training data set):
Para probar la exactitud del modelo se van a usar mamografías las cuales previamente fueron diagnosticadas con cancer
Para probar la exactitud del modelo se van a usar mamografías las cuales previamente fueron diagnosticadas con cancer
Detalles estadísticos sobre el modleo elegido
Implementar una interfaz gráfica de usuario (GUI) para el front-end de un micrositio web:
Implementar una interfaz gráfica de usuario (GUI) para el front-end de un micrositio web:
Un micrositio es una interfaz gráfica web que permite implementar en linea una única funcionalidad del sistema, esta tiene la ventaja que la interfaz es sencilla para el usuario, sin embargo es capaz de hacer trabajo interno complejo, como lo es procesar imágenes usando AI y ML.
Micrositio
Este es el código para generar el micrositio y hacerlo público en Wolfram Cloud
Ejemplos de como se deberia ver el micrositio
Fuente de Datos
Fuente de Datos
CBIS-DDSM: Breast Cancer Image Dataset
Curated Breast Imaging Subset DDSM Dataset (Mammography)
https://www.kaggle.com/datasets/awsaf49/cbis-ddsm-breast-cancer-image-dataset
5.3GB Zip
Mammogram Mastery: A Robust Dataset for Breast Cancer Detection and Medical Education
https://data.mendeley.com/datasets/fvjhtskg93/1
978GB Zip
Curated Breast Imaging Subset DDSM Dataset (Mammography)
https://www.kaggle.com/datasets/awsaf49/cbis-ddsm-breast-cancer-image-dataset
5.3GB Zip
Mammogram Mastery: A Robust Dataset for Breast Cancer Detection and Medical Education
https://data.mendeley.com/datasets/fvjhtskg93/1
978GB Zip
Conclusiones
Conclusiones
Se cosnidera una herramienta útil para una clínica en el interior de Costa Rica
Según las estadísticas mundiales, y también las de Costa Rica, el cáncer de mama sigue siendo la principal causa de muerte entre las mujeres. La Organización Mundial de la Salud reporta 6517 casos nuevos, lo que justifica un riesgo del 17,1 % de desarrollarlo antes de los 75 años.
Impacto Real
Un enfoque de aprendizaje semi-supervisado resulta científicamente útil para una clínica en el interior de Costa Rica, ya que aborda directamente las limitaciones típicas de los centros médicos pequeños con recursos limitados. Las clínicas fuera de las principales áreas urbanas suelen tener muy pocas imágenes de mamografía etiquetadas, dado que el número de radiólogos expertos es limitado y la anotación manual consume mucho tiempo. Al mismo tiempo, estas clínicas acumulan un gran número de imágenes sin etiquetar durante la atención de rutina. El aprendizaje semi-supervisado aprovecha este desequilibrio: permite que un modelo aprenda tanto de imágenes etiquetadas como sin etiquetar, mejorando el rendimiento de la clasificación incluso cuando los datos etiquetados de alta calidad son escasos. Este método también es valioso porque puede adaptar los modelos a las condiciones específicas de imagen de la clínica. El equipamiento de las clínicas rurales suele diferir del utilizado para crear conjuntos de datos públicos, y las poblaciones de pacientes también varían. El entrenamiento semi-supervisado, especialmente combinado con el aprendizaje por transferencia, ayuda al modelo a adaptarse a la distribución local de datos. Esto reduce la discrepancia entre los conjuntos de datos externos y las imágenes reales de la clínica, lo que permite predicciones más precisas para la población atendida. Desde la perspectiva del flujo de trabajo, los modelos semi-supervisados pueden ayudar a los clínicos en la detección precoz, sobre todo cuando el acceso a especialistas es limitado. Al resaltar posibles anomalías o señalar casos sospechosos, el sistema puede contribuir a reducir los retrasos en el diagnóstico. Esto es especialmente importante en las zonas rurales, donde los pacientes a menudo deben desplazarse largas distancias para recibir una evaluación especializada. Implementar un sistema de este tipo también es más factible que desarrollar un modelo totalmente supervisado. Los enfoques totalmente supervisados requieren miles de imágenes etiquetadas por expertos, algo que las clínicas pequeñas no pueden generar de forma realista. El aprendizaje semi-supervisado reduce significativamente este requisito, manteniendo un alto rendimiento diagnóstico. Con la supervisión adecuada, la gobernanza de datos y el apoyo computacional, potencialmente a través de asociaciones con universidades o instituciones externas, se convierte en una herramienta práctica para mejorar la precisión diagnóstica en entornos limitados.
Mejoras futuras
• Utilizar más conjuntos de datos para disponer de más información para su uso y comparación.
• Entrenar el dispositivo con un número determinado de imágenes de cáncer y de otras afecciones.
• Utilizar diferentes métodos y funciones de aprendizaje automático para encontrar el mejor resultado con los datos disponibles.
Aprendizajes personales
• La necesidad de grandes cantidades de información para que se entrenen correctamente las máquinas con los diferentes métodos de aprendizaje automático.
• La importancia del diagnóstico precoz de enfermedades.
• Cómo el uso de programas puede mejorar significativamente la atención médica.
• Las dificultades que enfrentan muchos países de bajos ingresos para detectar enfermedades como el cáncer debido a la lentitud de sus sistemas de diagnóstico.
Referencias & Documentación
Referencias & Documentación
◼
An Elementary Introduction to the Wolfram Language by Stephen Wolfram
https://www.wolfram.com/language/elementary-introduction/3rd-ed/
https://www.wolfram.com/language/elementary-introduction/3rd-ed/
◼
◼
Global Cancer Observatory
https://gco.iarc.who.int/media/globocan/factsheets/populations/188-costa-rica-fact-sheet.pdf
https://gco.iarc.who.int/media/globocan/factsheets/populations/188-costa-rica-fact-sheet.pdf
◼
Otros recursos: https://reference.wolfram.com/language/, https://www.wolfram.com/language/introduction-machine-learning/what-is-machine-learning/, https://www.breastcancer.org/es/pruebas-deteccion/mamografias, https://www.hopkinsmedicine.org/health/conditions-and-diseases/breast-cancer/invasive-ductal-carcinoma-idc, https://publications.iarc.who.int/Non-Series-Publications/World-Cancer-Reports/World-Cancer-Report-Cancer-Research-For-Cancer-Prevention-2020, https://gco.iarc.who.int/media/globocan/factsheets/populations/188-costa-rica-fact-sheet.pdf, https://pmc.ncbi.nlm.nih.gov/articles/PMC8892413/#Sec8, https://community.wolfram.com/groups/-/m/t/1383429, https://www.mdpi.com/2313-433X/9/5/95, https://pmc.ncbi.nlm.nih.gov/articles/PMC8892413/#Sec16