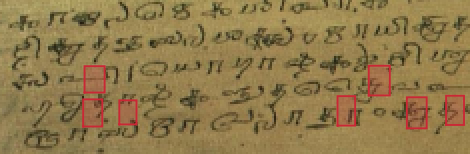
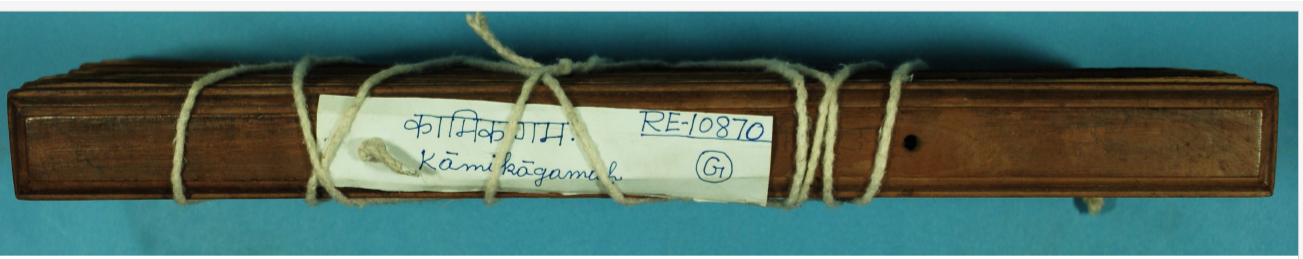
Historically used as writing material in the Indian subcontinent and Southeast Asia, there are an abundance of palm leaves with writing on them. Located in various locations at Museums, Universities and in Private collections. An initiative to digitize them has generated massive number of images that are currently outpacing all effort to transcribe it manually into computer readable text. This project will focus on using OCR techniques to extract Sanskrit text written using the Grantha script.
Palm Leaf Training Set
Palm Leaf Training Set
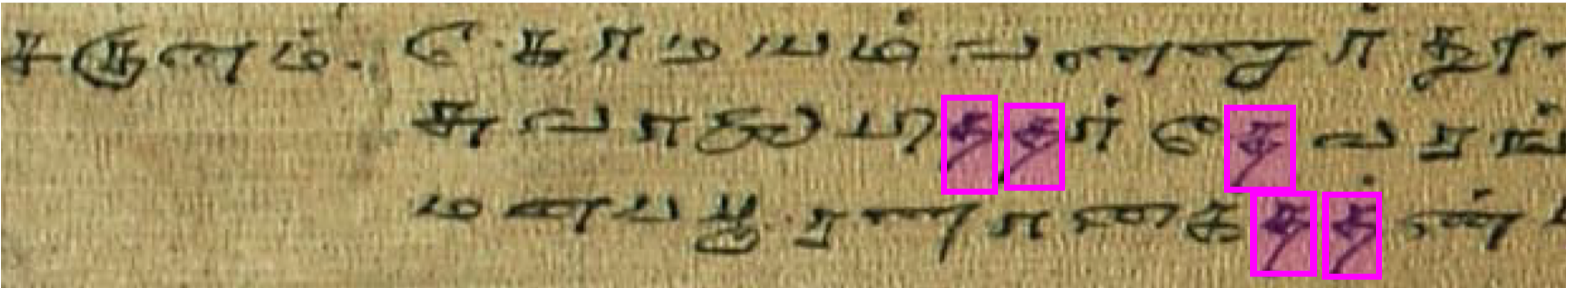
TrainImageContentDetector
TrainImageContentDetector
Used
dfGPU=TrainImageContentDetector[TrainingListTa]
Results
Results
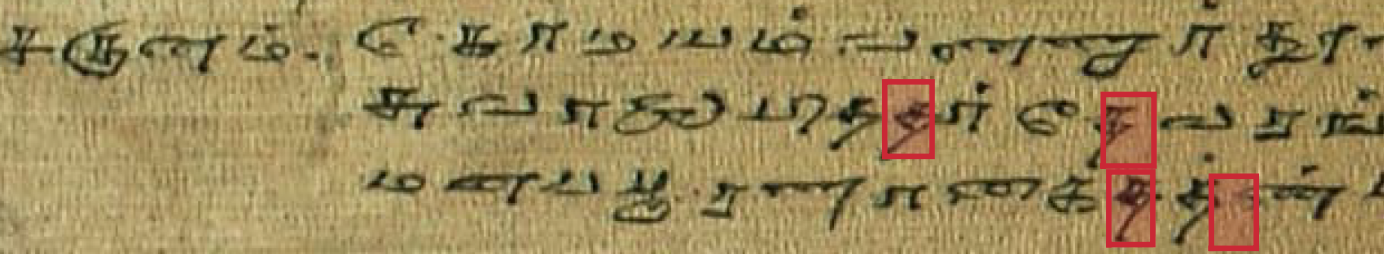
Encouragingly close but needs more training data.
In[]:=
HighlightImage[TrainingListTa〚1,1〛,Legended[#BoundingBox,#Class]&/@dfGPU[TrainingListTa〚1,1〛,{"BoundingBox","Class"}]]
Out[]=

In[]:=
HighlightImage[TrainingListTa〚-2,1〛,Legended[#BoundingBox,#Class]&/@dfGPU[TrainingListTa〚-2,1〛,{"BoundingBox","Class"}]]
Out[]=