Clasificación de Cáncer de Mama
Clasificación de Cáncer de Mama
Därä
Natalia Pastrana, Melissa Zamora, Emma Morales
15 de Noviembre del 2025
Natalia Pastrana, Melissa Zamora, Emma Morales
15 de Noviembre del 2025
1.Introducción
1.Introducción
El cáncer de mama es una enfermedad en la que células anormales del tejido mamario crecen de forma descontrolada, formando tumores que pueden invadir estructuras cercanas o propagarse a otras partes del cuerpo. Surge por una combinación de factores genéticos, hormonales y ambientales; y aunque cualquier persona puede desarrollarlo, el riesgo aumenta con la edad y con la presencia de mutaciones hereditarias. Las primeras etapas suelen presentarse sin síntomas, por lo que la detección temprana y un diagnóstico preciso son fundamentales.
Según la Organización Mundial de la Salud, el cáncer de mama es el tipo de cáncer más diagnosticado a nivel mundial, con más de 2.3 millones de nuevos casos cada año, y continúa siendo una de las principales causas de mortalidad por cáncer en mujeres. La detección temprana mejora significativamente las probabilidades de supervivencia, pero los métodos convencionales, como el examen clínico y la mamografía, presentan varias limitaciones. Diversos estudios han demostrado que las interpretaciones de mamografías pueden pasar por alto anomalías sutiles o generar falsos diagnósticos, especialmente en pacientes con tejido mamario denso. La mamografía permite identificar el cáncer observando masas y cambios estructurales en el tejido, pero su lectura es compleja y depende en gran medida de la experiencia del especialista.
El objetivo principal es desarrollar un modelo de clasificación automatizada capaz de distinguir entre imágenes con presencia de cáncer y aquellas sin indicios de la enfermedad. Para lograrlo, se empleará la función Classify, que permite entrenar redes neuronales de manera eficiente. Además, se implementará una interfaz gráfica en la nube para que los usuarios puedan subir imágenes de mamografías y obtener predicciones en tiempo real.
Agradecemos a los creadores de los conjuntos de datos de mamografías, así como a los investigadores que hicieron posible que estos recursos estuvieran disponibles para su uso científico.
2. Entrada Computacional y Explicación del Código
2. Entrada Computacional y Explicación del Código
2.1 Carga y Organización de Datos (RETO 1)
2.1 Carga y Organización de Datos (RETO 1)
El primer paso en cualquier proyecto de aprendizaje automático es la carga y organización de los datos.
In[]:=
SetDirectory[NotebookDirectory[]];Directory[]
Out[]=
C:\Users\CientificoAlajuela89\Documents\Hackaton
In[]:=
FolderIBCD=Directory[]<>"/IBCD"
Out[]=
C:\Users\CientificoAlajuela89/IBCD
En este caso, trabajamos con imágenes de mamografías almacenadas en carpetas locales. El dataset está organizado en dos categorías: imágenes con cáncer e imágenes sin cáncer. Decidimos importar los folders de esta manera porque resulta más práctico al estar previamente ordenados en sus respectivas carpetas.
La función FileNames nos permite buscar todos los archivos con extensión .jpg en las carpetas especificadas. Esto es fundamental, ya que necesitamos acceder a todas las imágenes disponibles para entrenar nuestro modelo.
La función FileNames nos permite buscar todos los archivos con extensión .jpg en las carpetas especificadas. Esto es fundamental, ya que necesitamos acceder a todas las imágenes disponibles para entrenar nuestro modelo.
In[]:=
examNoCancer="C:\Users\CientificoAlajuela89\Downloads\Mamografias\Mammogram Mastery A Robust Dataset for Breast Cancer Detection and Medical Education\Breast Cancer Dataset\Original Dataset\Non-Cancer";examCancer="C:\Users\CientificoAlajuela89\Downloads\Mamografias\Mammogram Mastery A Robust Dataset for Breast Cancer Detection and Medical Education\Breast Cancer Dataset\Original Dataset\Cancer";examImagesCancer=FileNames["*jpg",examCancer,Infinity];examImagesNoCancer=FileNames["*jpg",examNoCancer,Infinity];
Puedes interactuar con las imágenes de alguno de estos folders usando la función Manipulate, la cual permite crear controles dinámicos para explorar el contenido de manera sencilla. Ejemplo:
In[]:=
Manipulate[Column[{n,examImagesCancer[[n]],Image[Import[examImagesCancer[[n]]],ImageSize->Small]}],{n,1,Length[examImagesCancer],1},SaveDefinitions->True]
Out[]=


2.2 Preparación del Conjunto de Entrenamiento (RETO 2)
2.2 Preparación del Conjunto de Entrenamiento (RETO 2)
Una vez que tenemos las rutas de todas las imágenes, el siguiente paso es preparar el conjunto de datos de entrenamiento. Es importante seleccionar una muestra representativa de cada categoría.
En este caso, utilizamos RandomSample para seleccionar aleatoriamente 120 imágenes con cáncer y 120 imágenes sin cáncer.
La función Map aplica Import a cada ruta de imagen, cargando las imágenes en memoria para su posterior procesamiento.
En este caso, utilizamos RandomSample para seleccionar aleatoriamente 120 imágenes con cáncer y 120 imágenes sin cáncer.
La función Map aplica Import a cada ruta de imagen, cargando las imágenes en memoria para su posterior procesamiento.
In[]:=
trainingCancerData=Map[ColorConvert[ImageResize[Import[#],600],"Grayscale"]&,RandomSample[examImagesCancer,120]];trainingNoCancerData=Map[ColorConvert[ImageResize[Import[#],300],"Grayscale"]&,RandomSample[examImagesNoCancer,120]];
2.3 Entrenamiento del Clasificador (RETO 3)
2.3 Entrenamiento del Clasificador (RETO 3)
El corazón de este proyecto es el entrenamiento del clasificador. Utilizamos la función de Wolfram Language, que es una herramienta que simplifica el proceso de aprendizaje automático.
El clasificador se entrena con un diccionario (Asociación en Wolfram Language) que mapea etiquetas de clase a conjuntos de imágenes. En nuestro caso:
lista de imágenes con cáncer.
lista de imágenes sin cáncer.
Classify
El clasificador se entrena con un diccionario (Asociación en Wolfram Language) que mapea etiquetas de clase a conjuntos de imágenes. En nuestro caso:
"Cancer"->
"No Cancer"->
In[]:=
CancerClassify=Classify[<|"Cancer"->trainingCancerData,"No Cancer"->trainingNoCancerData|>]
Out[]=
ClassifierFunction


3. Salida Computacional y Explicación del Modelo
3. Salida Computacional y Explicación del Modelo
3.1 Visualización del Modelo Entrenado
3.1 Visualización del Modelo Entrenado
Una vez entrenado el clasificador, Wolfram Language nos proporciona automáticamente información sobre el modelo. Al evaluar la variable , podemos ver:
CancerClassify
In[]:=
Information[CancerClassify]
Out[]=

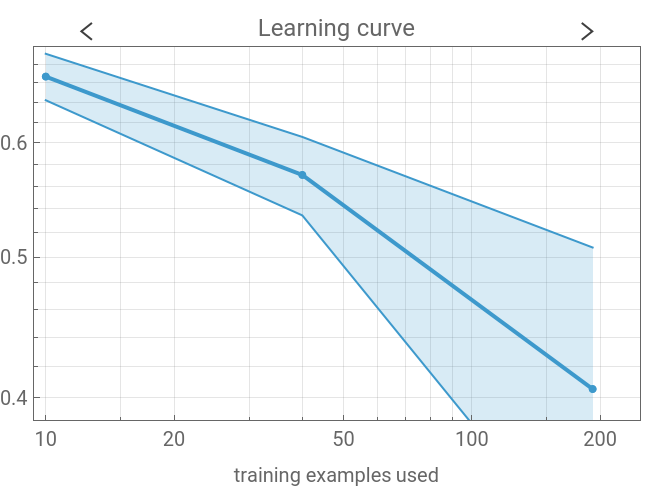
Esta información es crucial para entender las capacidades y limitaciones de nuestro clasificador.
3.2 Métodos del Clasificador
3.2 Métodos del Clasificador
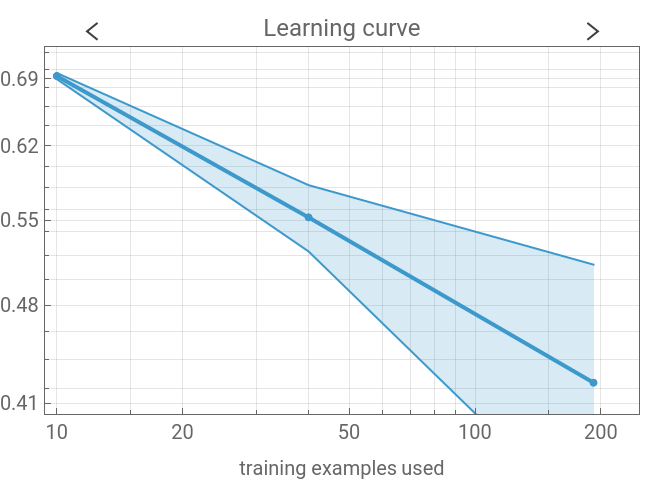
En Wolfram Language, cuando se entrena un Classify, el sistema selecciona automáticamente el método que considera más adecuado según las características del dataset. Sin embargo, para este proyecto decidimos probar tres métodos distintos de forma manual con el fin de comparar su desempeño. Como se ve a continuación, ademas del automático, probamos Gradient Boosted Trees, Neural Network y Nearest Neighbors, evaluando en cada uno su precisión, estabilidad y capacidad para manejar imágenes.
In[]:=
CancerClassify=Classify[<|"Cancer"->trainingCancerData,"No Cancer"->trainingNoCancerData|>,Method->"GradientBoostedTrees"]
Out[]=
ClassifierFunction
In[]:=
Information[CancerClassify]
Out[]=
In[]:=
CancerClassify=Classify[<|"Cancer"->trainingCancerData,"No Cancer"->trainingNoCancerData|>,Method->"NeuralNetwork"]
Out[]=
ClassifierFunction
In[]:=
Information[CancerClassify]
Out[]=
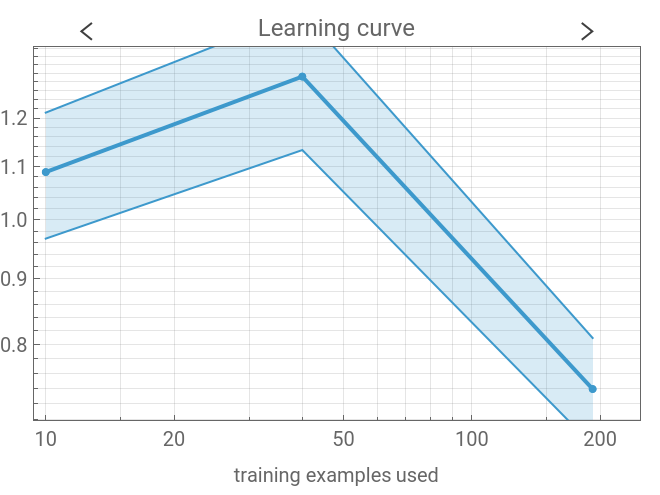
Usamos Logistic Regression porque nos dio un acierto razonable, pero no es la opción óptima para este proyecto. Los clasificadores lineales como Logistic Regression funcionan bien con datos simples o lineales, pero las imágenes de mamografías tienen patrones muy complejos y sutiles que este modelo puede pasar por alto. En cambio, Neural Networks es más adecuado para este tipo de tarea porque puede reconocer patrones visuales complejos y variaciones sutiles en las imágenes. Además, tienden a ser más estables en el sentido de que su rendimiento no varía tanto cuando cambian ligeramente los datos de entrenamiento, algo que Logistic Regression puede experimentar.
3.2 Pruebas
3.2 Pruebas
Podemos probar el clasificador con imágenes externas al modelo:
Nos permite también conocer la probabilidad:
Aquí podemos ver la información puesta en un PieChart:
El gráfico nos permite evidenciar de forma visual el porcentaje.
4. Subir el Código a la Nube
4. Subir el Código a la Nube
4.1 RETO 4
4.1 RETO 4
4.1.1 Visto en la Página
4.1.1 Visto en la Página
4.2 Microsite
4.2 Microsite
Ahora finalmente para hacer el modelo accesible en linea, creamos un sitio web con GUI que permite introducir la edad , la ubicación, y el nombre. En este puedes subir una mamografia y tener el resultado. Con esto obtuvimos el CloudObject.
4.3 Innovar: Somos la Costa Rica del Futuro
4.3 Innovar: Somos la Costa Rica del Futuro
Ideamos un código capaz de guardar la información y las imágenes en la nube, lo que permite realizar análisis demográficos de manera eficiente. Además, el sitio recolecta automáticamente las mamografías que se van añadiendo, facilitando futuras actualizaciones del modelo y ampliando la base de datos para nuevos análisis.
4.3.1 Explicación de las variables
4.3.1 Explicación de las variables
prediccion: Es el resultado de Cancer o No Cancer del CancerClassify.
carpeta: Es una carpeta llamada RegistrosClasificador que existe en WolframCloud, y si nota que no existe, lo crea.
carpetaImagenes: Crea una carpeta dedicada a las imágenes importadas, está dentro de la carpeta general. Si no exite la crea.
nombreImagen: le da un nombre único a cada imagen formado por el año, mes, día, hora, minuto y segundo en el que el formulario del sitio fue enviado.
archivo: Es el conjunto de datos del registro, se eligió el formato .json ya que este abre directamente en la nube, y es más fácil acceder , contrario al .wxf que se descarga para visualizar la información. Si no existe lo crea.
registrosPrevios: Guarda todos los registros previos del microsite y añade el nuevo cada vez que se envía un formulario.
4.3.2 Visto en la Página
4.3.2 Visto en la Página
5. ¿Cómo podría esta herramienta ayudar a una clínica en el interior de Costa Rica?
5. ¿Cómo podría esta herramienta ayudar a una clínica en el interior de Costa Rica?
Una herramienta como esta permitiría que incluso clínicas pequeñas o en el interior del país puedan recibir apoyo para analizar mamografías, detectar posibles casos antes y mejorar la prevención y atención temprana. Además, pone en evidencia lo importante que es usar la tecnología para facilitar el acceso a la salud y apoyar a quienes más lo necesitan.
Este tipo de herramientas, alimentadas con información local tienen un valor enorme porque permiten que los modelos se adapten a la realidad específica de Costa Rica, mejorando la precisión y utilidad de los análisis. Al mismo tiempo, promueven al país como un lugar que apoya la salud de las mujeres y la innovación tecnológica, demostrando cómo la ciencia y la tecnología pueden trabajar juntas para resolver problemas sociales y mejorar la calidad de vida de la población.
Este tipo de herramientas, alimentadas con información local tienen un valor enorme porque permiten que los modelos se adapten a la realidad específica de Costa Rica, mejorando la precisión y utilidad de los análisis. Al mismo tiempo, promueven al país como un lugar que apoya la salud de las mujeres y la innovación tecnológica, demostrando cómo la ciencia y la tecnología pueden trabajar juntas para resolver problemas sociales y mejorar la calidad de vida de la población.
5.1 Que el Mundo te Conozca
5.1 Que el Mundo te Conozca
Este proyecto es importante porque, a gran escala, podría implementarse en hospitales para acelerar la revisión de mamografías con evidentes indicios de cáncer, permitiendo que los casos más críticos se detecten y atiendan lo antes posible, mejorando la prevención temprana y la atención de los pacientes. . Con la cantidad de data que tienen los hospitales, el proyecto sería cada vez más confiable. El modelo ayuda a identificar rápidamente las imágenes con posible cáncer, permitiendo que los casos más críticos se detecten y atiendan lo antes posible, mejorando la prevención temprana y la atención de los pacientes.
Piensa desde antes del proyecto: Imagina un simple código QR afuera del consultorio que te invita a subir tu mamografía, esto con el fin de ayudar a recopilar más datos y contribuir a un proyecto futuro que puede mejorar la detección temprana de cáncer de mama. Cada imagen cuenta para el bien de todas las mujeres y para fortalecer la investigación.
6. Accesibilidad de los Datos
6. Accesibilidad de los Datos
La accesibilidad de los datos es clave para el funcionamiento de este proyecto. Al estar almacenados en la nube, la información y las imágenes se pueden manejar, actualizar y analizar desde cualquier lugar, lo que facilita la revisión continua y futuras mejoras del modelo. Esta accesibilidad también permite que los datos se utilicen de manera eficiente para investigación, actualización de predicciones y fortalecimiento del proyecto, asegurando que cada nuevo aporte pueda mejorar la herramienta con el tiempo.
6.1 Carpetas y registros en la nube
6.1 Carpetas y registros en la nube
6. 2 Graficar con los datos: ver la Costa Rica de Hoy
6. 2 Graficar con los datos: ver la Costa Rica de Hoy
7. Conclusiones
7. Conclusiones
El proyecto ha brindado múltiples oportunidades tanto de desarrollo del pensamiento critico, como habilidades blandas y la resolución de problemas con un tiempo limitado y bajo presión.
A) Aprendizaje del equipo:
Cada una de las participantes ha demostrado un aprendizaje significativo en relación al entendimiento y utilización del lenguaje de programación Wolfram, además de una necesidad del manejo del tiempo de manera eficiente, el trabajo en equipo para llevar a cabo el código de la mejor forma posible.
B) Retos y Limitaciones
El mayor reto de este proyecto ha sido el tiempo necesario para analizar, estructurar y comprender todas las herramientas tecnológicas involucradas. Diseñar un modelo funcional, preparar los datos, construir el micrositio y asegurarse de que todo se integrara correctamente requirió muchas horas de trabajo continuo. Cada parte del proyecto demandó aprendizaje, pruebas y ajustes constantes, lo que hizo que el proceso fuera intenso, pero también muy formativo y valioso para lograr un sistema que realmente funcione y pueda ayudar en un contexto real.
8. Referencias
8. Referencias
Software utilizado:
- Wolfram Mathematica 14.3
- Wolfram Language
Datasets:
CBIS-DDSM: Breast Cancer Image Dataset
Curated Breast Imaging Subset DDSM Dataset (Mammography)
https://www.kaggle.com/datasets/awsaf49/cbis-ddsm-breast-cancer-image-dataset
5.3GB Zip
Mammogram Mastery: A Robust Dataset for Breast Cancer Detection and Medical Education
https://data.mendeley.com/datasets/fvjhtskg93/1
978GB Zip
Articulos cientificos:
Wolfram, S. (2023). An Elementary Introduction to the Wolfram Language. https://www.wolfram.com/language/elementary-introduction/2nd-ed/index.html.es
Awsaf. (2021). Curated Breast Imaging Subset DDSM Dataset (Mammography) [Data set]. In CBIS-DDSM: Breast Cancer Image Dataset. https://www.kaggle.com/datasets/awsaf49/cbis-ddsm-breast-cancer-image-dataset
Abdalla, P. A. (2024). Mammogram mastery: A robust dataset for breast cancer detection and medical education [Data set]. Mendeley Data. https://doi.org/10.17632/FVJHTSKG93.1
Agradecimientos:
- A los investigadores y médicos que recopilaron y etiquetaron las imágenes
- A la comunidad científica por el acceso abierto a datasets médicos